

Ses kopyalama, Gemini API Voices uç noktasını (POST /v1beta/voices) kullanarak kısa bir ses örneğinden konuşmacının ses özelliklerini kopyalamanıza olanak tanır. Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) ve Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts) modelleri ses kopyalamayı destekler.
İzinleri kopyalamanın, doğrulamanın ve kopyalanan bir sesi denemenin en hızlı yolu, Google AI Studio'daki etkileşimli Ses Kopyalama deneyimidir. Referans ve izin kliplerini doğrudan tarayıcıda kaydedebilir veya yükleyebilir, sesi önizleyebilir ve sonuç olarak elde edilen voice_... kimliğini doğrudan uygulama kodunuza kopyalayabilirsiniz.
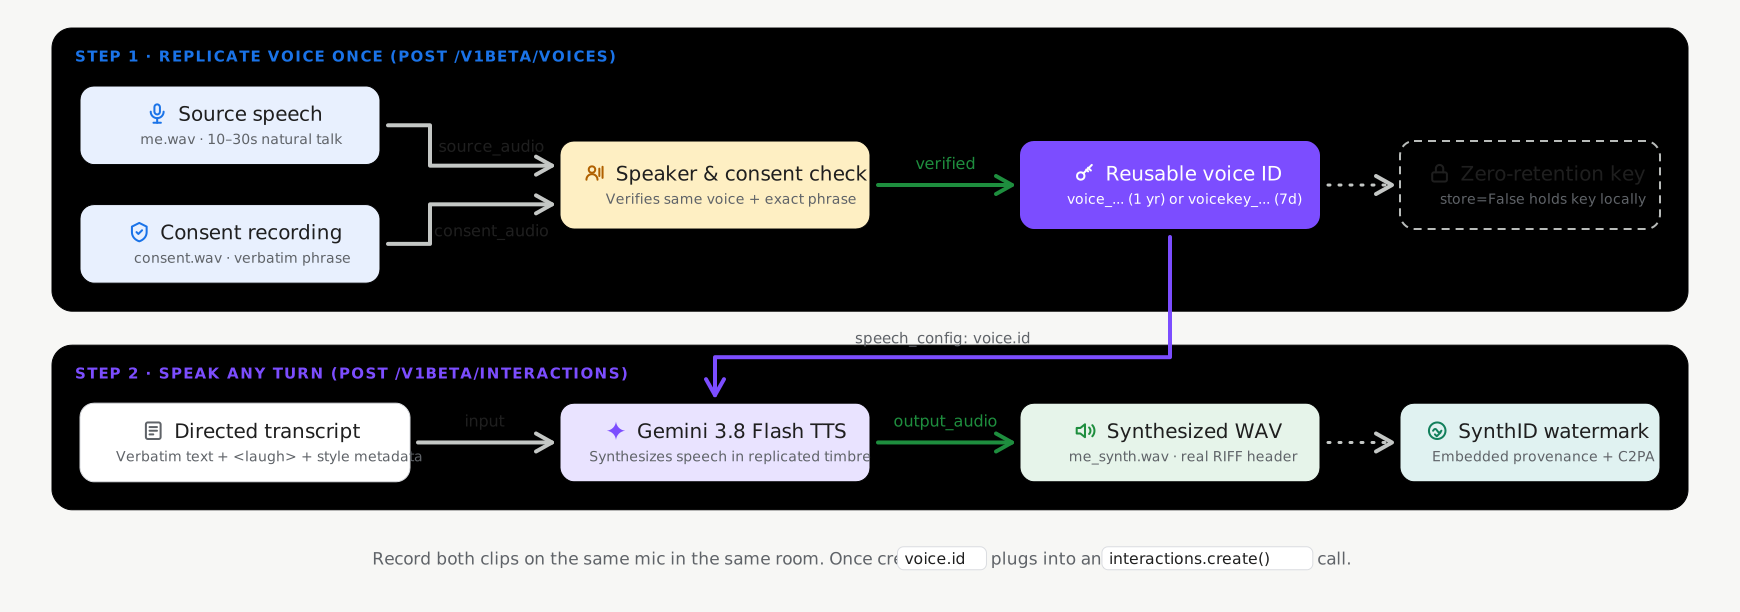
Durumlu ve durumsuz depolama modları
Ses kopyalama, voices.create aranırken iki depolama modunu destekler POST /v1beta/voices. Durumlu depolama varsayılan olarak etkindir:
- Durumlu depolama (
store=True, önerilen varsayılan): Google, doğrulanmış ses profilinizi projenizde depolar ve hafif, kalıcı birvoice_id(replicated_voice.id, örneğinvoice_abc123...) döndürür. Buvoice_id'yi istekler arasında iletebilir vevoices.list(),voices.get()vevoices.delete()ile yönetebilirsiniz. - Durum bilgisiz istemci tarafından yönetilen anahtarlar (
store=False, isteğe bağlı): Biyometrik ses profillerinin sunucu tarafında kalıcı olmasını gerektirmeyen iş yükleri içinstore=Falsedeğerini ayarlayın. API, uygulamanızın yerel olarak depoladığı ve sentez isteklerinde doğrudan ilettiği şifrelenmiş, bağımsız birvoice_key(replicated_voice.key,voicekey_...ile başlar) döndürür.
| Depolama modu | Tanımlayıcı | Proje sınırı | Elde tutma (TTL) |
|---|---|---|---|
Durumlu sesler (store=True) |
voice_... |
Proje başına 200 ses (istemde kullanılan ve kopyalanan sesler arasında paylaşılır) | 1 yıl |
Durum bilgisiz ses anahtarları (store=False) |
voicekey_... |
Müşteri tarafından yönetilen | 7 gün |
Ses ve izin şartları
Her CreateVoice çoğaltma isteği için aynı yetişkin konuşmacıdan alınmış iki gerçek insan ses kaydı gerekir (24 kHz mono 16 bit WAV önerilir):
- Referans ses (
source_audio): Sesini kopyalamak istediğiniz konuşmacının 10-30 saniyelik temiz ve doğal konuşma klibi. - İzin ses kaydı (
consent_audio): Aynı konuşmacının, zorunlu izin beyanını desteklenen dillerden birinde (ör. İngilizce) net bir şekilde okuduğu kayıt: > "Bu sesin sahibi benim ve Google'ın sentetik bir ses modeli oluşturmak için bu sesi kullanmasına izin veriyorum."
Kopyalanmış ses oluşturma (durumlu varsayılan)
Projenizde kopyalanmış bir ses profili oluşturup kaydetmek için Google GenAI SDK'sını (google-genai 2.25.0+ / @google/genai 2.24.0+) veya REST API'yi store=True ile kullanın:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
Klonlanmış sesinizle konuşma sentezleme
Sentez isteğinizde döndürülen id (voice_...) öğesini iletin:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
Depolanan çoğaltılmış sesleri yönetme
store=True ile oluşturulan kopyalanmış sesler, Voices API aracılığıyla listelenebilir, filtrelenebilir, incelenebilir ve silinebilir (tüm filtre parametreleri için Genişletilmiş Ses Kitaplığı ve filtreleme bölümüne bakın):
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Seçenek: Durumsuz istemci tarafından yönetilen ses anahtarları (store=False)
Uygulamanızın ses profillerinin sunucu tarafında kalıcı olmaması gerekiyorsa, çoğaltılmış sesi oluştururken store=False değerini ayarlayın. API, istemci tarafında depoladığınız ve voice kimliğinin kabul edildiği her yere doğrudan ilettiğiniz şifrelenmiş bir voice_key (replicated_voice.key, voicekey_... ile başlar) döndürür:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
Dile göre desteklenen izin ifadeleri
İzin ses kaydında, desteklenen 30 yerel ayar dilinden birinde tam olarak şu ifade okunmalıdır:
| Dil | Yerel ayar (lang_id) |
Ayrıntılı İzin Beyanı |
|---|---|---|
| Arapça | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| Bengalce | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| Çince (Basitleştirilmiş) | zh-CN |
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| Felemenkçe | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| İngilizce (ABD) | en-US |
Bu sesin sahibi benim ve Google'ın sentetik bir ses modeli oluşturmak için bu sesi kullanmasına izin veriyorum. |
| English (UK) | en-GB |
Bu sesin sahibi benim ve Google'ın sentetik bir ses modeli oluşturmak için bu sesi kullanmasına izin veriyorum. |
| İngilizce (Hindistan) | en-IN |
Bu sesin sahibi benim ve Google'ın sentetik ses modeli oluşturmak için bu sesi kullanmasına izin veriyorum. |
| İngilizce (Avustralya) | en-AU |
Bu sesin sahibi benim ve Google'ın sentetik bir ses modeli oluşturmak için bu sesi kullanmasına izin veriyorum. |
| Fransızca (Fransa) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| Fransızca (Kanada) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| Almanca | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| Güceratça | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| Hintçe | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| Endonezce | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| İtalyanca | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| Japonca | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| Kannada | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| Korece | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| Malayalamca | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| Marathice | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| Lehçe | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| Portekizce (Brezilya) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| Rusça | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| İspanyolca (İspanya) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| İspanyolca (ABD) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| Tamilce | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| Teluguca | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| Thai | th-TH |
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์ |
| Türkçe | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| Vietnamese | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
Referans ses kaydıyla ilgili en iyi uygulamalar
- Sessiz bir ortamda kayıt yapın: Oda yankısını, arka plan gürültüsünü, müziği ve üst üste gelen sesleri en aza indirin.
- Kayıt koşullarını eşleştirin: Konuşmacı doğrulama kontrolünün güvenilir bir şekilde başarılı olması için hem
source_audiohem deconsent_audioöğesini aynı akustik ortamda aynı mikrofonda kaydedin. - 24 kHz mono WAV'ye dönüştürme: En iyi sonuçları elde etmek için kodlamadan önce giriş sesini 24 kHz mono 16 bit PCM WAV olarak yeniden örnekleyin.
Sırada ne var?
- Ses tasarımı bölümünde metin açıklamalarından nasıl özel karakterler oluşturacağınızı öğrenin.
- Metin okuma kılavuzunda dönüş seviyesinde stil, satır içi etiketler ve çok konuşmacılı diyalog özelliklerini keşfedin.