

Tính năng nhân bản giọng nói cho phép bạn nhân bản đặc điểm giọng nói của người nói từ một đoạn âm thanh ngắn bằng cách sử dụng điểm cuối Giọng nói của Gemini API (POST /v1beta/voices). Cả Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) và Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts) đều hỗ trợ tính năng nhân bản giọng nói.
Cách nhanh nhất để sao chép, xác minh sự đồng ý và nghe thử giọng nói được sao chép là sử dụng trải nghiệm Sao chép giọng nói có tính tương tác trong Google AI Studio. Bạn có thể ghi lại hoặc tải các đoạn video tham chiếu và đoạn video có sự đồng ý lên ngay trong trình duyệt, xem trước giọng nói và sao chép mã nhận dạng voice_... thu được trực tiếp vào mã ứng dụng của mình.
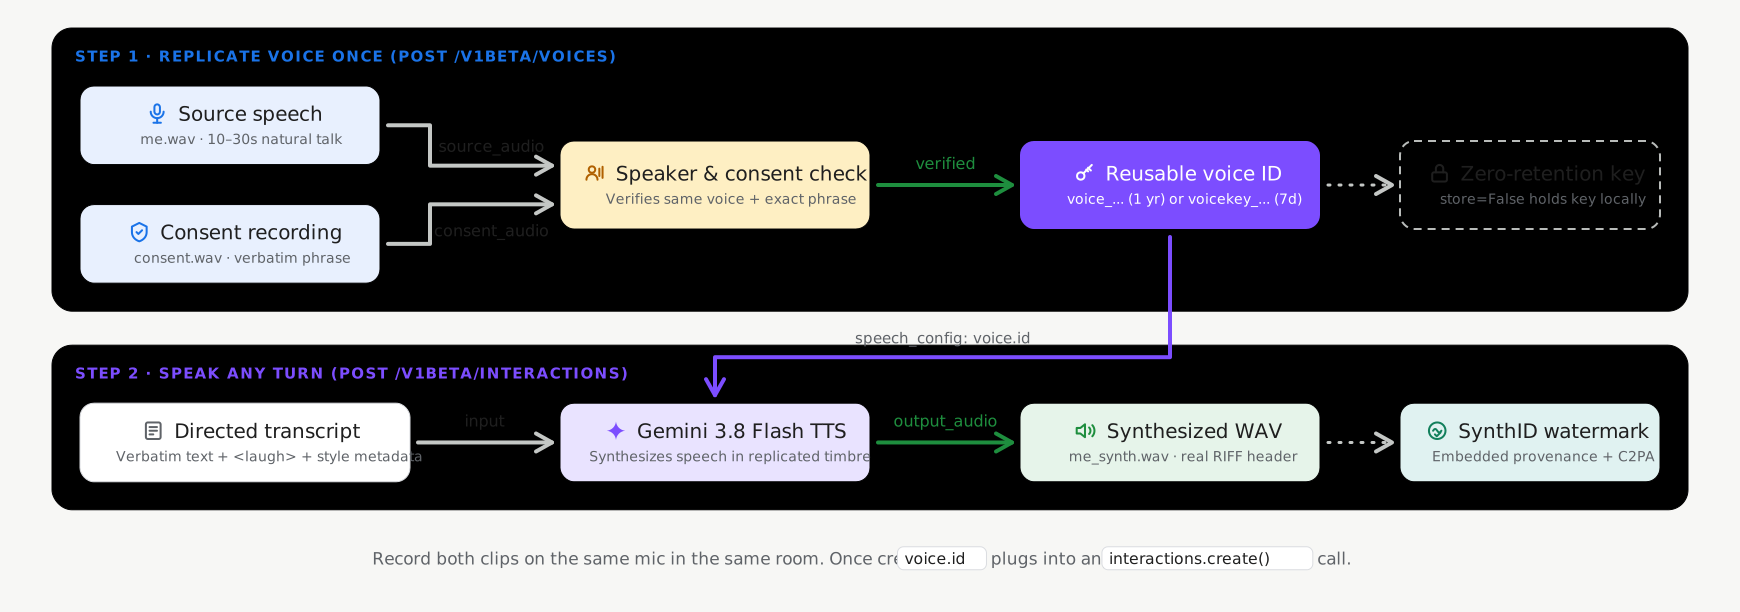
Chế độ lưu trữ có trạng thái so với chế độ lưu trữ không có trạng thái
Tính năng nhân bản giọng nói hỗ trợ 2 chế độ lưu trữ khi gọi voices.create (POST /v1beta/voices), trong đó chế độ lưu trữ có trạng thái được bật theo mặc định:
- Bộ nhớ có trạng thái (
store=True, mặc định nên dùng): Google lưu trữ hồ sơ giọng nói đã xác minh trong dự án của bạn và trả về mộtvoice_id(replicated_voice.id, chẳng hạn nhưvoice_abc123...) liên tục, có dung lượng nhỏ. Bạn có thể truyềnvoice_idnày qua các yêu cầu và quản lý bằngvoices.list(),voices.get()vàvoices.delete(). - Khoá do ứng dụng không trạng thái quản lý (
store=False, không bắt buộc): Đối với các khối lượng công việc yêu cầu không có sự duy trì phía máy chủ đối với hồ sơ giọng nói sinh trắc học, hãy đặtstore=False. API này trả về mộtvoice_key(replicated_voice.key, bắt đầu bằngvoicekey_...) được mã hoá, độc lập mà ứng dụng của bạn lưu trữ cục bộ và truyền trực tiếp trong các yêu cầu tổng hợp.
| Chế độ lưu trữ | Số nhận dạng | Hạn mức dự án | Thời gian lưu giữ (TTL) |
|---|---|---|---|
Giọng nói có trạng thái (store=True) |
voice_... |
200 giọng nói cho mỗi dự án (được chia sẻ giữa giọng nói được tạo theo yêu cầu và giọng nói được sao chép) | 1 năm |
Khoá giọng nói không trạng thái (store=False) |
voicekey_... |
Do ứng dụng quản lý | 7 ngày |
Yêu cầu về âm thanh và sự đồng ý
Mỗi yêu cầu sao chép CreateVoice đều yêu cầu 2 bản ghi âm giọng nói của người thật từ cùng một người nói là người lớn (nên dùng WAV đơn âm 16 bit 24 kHz):
- Âm thanh tham chiếu (
source_audio): Một đoạn âm thanh dài từ 10 đến 30 giây, có giọng nói tự nhiên, rõ ràng của người mà bạn muốn mô phỏng giọng. - Âm thanh đồng ý (
consent_audio): Bản ghi âm giọng nói của chính người nói đó, trong đó người nói đọc rõ ràng câu đồng ý bắt buộc bằng một trong các ngôn ngữ được hỗ trợ (ví dụ: bằng tiếng Anh): > "Tôi là chủ sở hữu giọng nói này và tôi đồng ý để Google sử dụng giọng nói này nhằm tạo mẫu giọng nói."
Tạo giọng nói được sao chép (mặc định có trạng thái)
Sử dụng Google GenAI SDK (google-genai 2.25.0 trở lên / @google/genai 2.24.0 trở lên) hoặc API REST với store=True để tạo và lưu hồ sơ giọng nói được sao chép trong dự án của bạn:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
Tổng hợp lời nói bằng giọng nói được sao chép
Truyền id (voice_...) đã trả về trong yêu cầu tổng hợp của bạn:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
Quản lý giọng nói được sao chép đã lưu trữ
Khi được tạo bằng store=True, bạn có thể liệt kê, lọc, kiểm tra và xoá các giọng nói được sao chép thông qua Voices API (xem Thư viện giọng nói mở rộng và lọc để biết tất cả các tham số bộ lọc):
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Lựa chọn: Khoá giọng nói do ứng dụng khách quản lý không trạng thái (store=False)
Nếu ứng dụng của bạn không yêu cầu duy trì hồ sơ giọng nói phía máy chủ, hãy đặt store=False khi tạo giọng nói sao chép. API này trả về một voice_key được mã hoá (replicated_voice.key, bắt đầu bằng voicekey_...) mà bạn lưu trữ phía máy khách và truyền trực tiếp đến bất cứ nơi nào chấp nhận mã nhận dạng voice:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
Các cụm từ đồng ý được hỗ trợ theo ngôn ngữ
Bản ghi âm đồng ý phải đọc rõ ràng nội dung chính xác bằng một trong 30 ngôn ngữ được hỗ trợ:
| Ngôn ngữ | Ngôn ngữ (lang_id) |
Tuyên bố đồng ý nguyên văn |
|---|---|---|
| Tiếng Ả Rập | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| Tiếng Bengali | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| Tiếng Trung (Giản thể) | zh-CN |
Tôi là chủ sở hữu của giọng nói này và cho phép Google sử dụng giọng nói này để tạo mô hình tổng hợp giọng nói |
| Tiếng Hà Lan | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| Tiếng Anh (Mỹ) | en-US |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mẫu giọng nói tổng hợp. |
| Tiếng Anh (Anh) | en-GB |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mẫu giọng nói tổng hợp. |
| Tiếng Anh (Ấn Độ) | en-IN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho phép Google sử dụng giọng nói này để tạo mẫu giọng nói tổng hợp. |
| Tiếng Anh (Úc) | en-AU |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mẫu giọng nói tổng hợp. |
| Tiếng Pháp (Pháp) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| Tiếng Pháp (Canada) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| Tiếng Đức | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| Tiếng Gujarati | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| Tiếng Hindi | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| Tiếng Indonesia | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| Tiếng Ý | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| Tiếng Nhật | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| Tiếng Kannada | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| Tiếng Hàn | ko-KR |
Tôi là chủ sở hữu của giọng nói này và cho phép Google sử dụng giọng nói này để tạo mô hình tổng hợp giọng nói. |
| Tiếng Malayalam | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| Tiếng Marathi | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| Tiếng Ba Lan | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| Tiếng Bồ Đào Nha (Brazil) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| Tiếng Nga | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| Tiếng Tây Ban Nha (Tây Ban Nha) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| Tiếng Tây Ban Nha (Mỹ) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| Tiếng Tamil | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| Tiếng Telugu | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| Tiếng Thái | th-TH |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói nhân tạo |
| Tiếng Thổ Nhĩ Kỳ | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| Tiếng Việt | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
Các phương pháp hay nhất để ghi âm thanh tham chiếu
- Ghi âm trong môi trường yên tĩnh: Giảm thiểu tiếng vọng trong phòng, tạp âm, nhạc và giọng nói chồng chéo.
- Điều kiện ghi âm trùng khớp: Ghi âm cả
source_audiovàconsent_audiotrên cùng một micrô trong cùng một môi trường âm thanh để quy trình xác minh người nói diễn ra thành công một cách đáng tin cậy. - Chuyển đổi sang WAV đơn âm 24 kHz: Để có kết quả tốt nhất, hãy lấy mẫu lại âm thanh đầu vào thành WAV PCM 16 bit đơn âm 24 kHz trước khi mã hoá.
Bước tiếp theo
- Tìm hiểu cách tạo chân dung người dùng tuỳ chỉnh từ nội dung mô tả bằng văn bản trong Thiết kế giọng nói.
- Khám phá kiểu theo lượt, thẻ nội tuyến và đoạn hội thoại nhiều người nói trong Hướng dẫn chuyển văn bản sang lời nói.