

জেমিনি লাইভ এপিআই জেমিনি মডেলগুলোর সাথে রিয়েল-টাইম, দ্বিমুখী ভয়েস কথোপকথন সক্ষম করে।
সাধারণ ভয়েস মডেলগুলো তাৎক্ষণিক কথোপকথনের জন্য বেশ ভালো কাজ করে। আপনি মডেলটির সাথে কথা বলেন এবং এটি সঙ্গে সঙ্গে একটি মৌখিক উত্তর তৈরি করে। কিন্তু যখন কোনো অনুরোধের জন্য পরিকল্পনা, জটিল বিশ্লেষণ বা বাহ্যিক টুলের প্রয়োজন হয়, তখন সরাসরি উত্তর দেওয়ার একটি সীমাবদ্ধতা তৈরি হয়। মডেলটিকে হয় কোনো কারণ ছাড়াই উত্তর দিতে হয়, অথবা টুলগুলোর কাজ শেষ হওয়ার জন্য নীরবে অপেক্ষা করতে হয়।
লাইভ এপিআই-তে থিঙ্কিং ( gemini-3.8-live-extended-thinking ) রিয়েল-টাইম ভয়েস সেশনে ব্যাকগ্রাউন্ড রিজনিং যোগ করে। মডেলটি ব্যাকগ্রাউন্ডে পরিকল্পনা করে এবং অ্যাসিঙ্ক্রোনাস টুলগুলোকে কল করে, এবং একই সাথে ইন্টারঅ্যাকশন সক্রিয় রাখতে স্বাভাবিক কথোপকথনের মতো কথা বলে।
এই স্থাপত্যটি কথোপকথনের জীবনচক্রকে দুটি প্রধান উপায়ে পরিবর্তন করে:
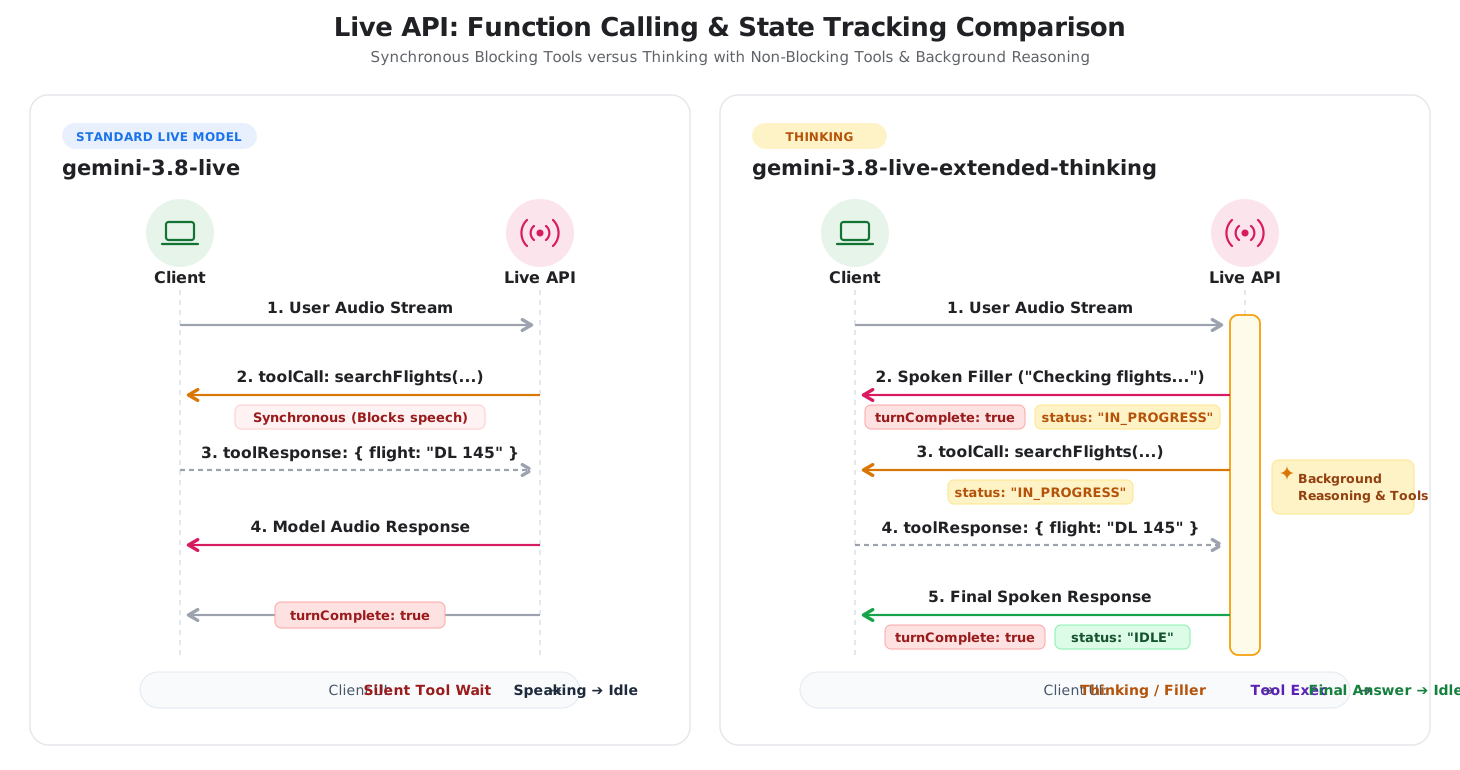
- কথোপকথনের ফাঁক পূরণের শব্দ : মডেলটি ব্যাকগ্রাউন্ডে টুলগুলো চালানোর সময় মধ্যবর্তী আপডেটগুলো বলে (যেমন "এখন ফ্লাইটের বিকল্পগুলো পরীক্ষা করা হচ্ছে")।
- ইন্টারঅ্যাকশন স্ট্যাটাস ট্র্যাকিং : যেহেতু মডেলটি একটি অনুরোধের সময় একাধিকবার যোগাযোগ করতে পারে, তাই সার্ভার ব্যাকগ্রাউন্ড প্রসেসিং চলাকালীন
interaction_status: "IN_PROGRESS"এবং সামগ্রিক কাজটি সম্পন্ন হলেinteraction_status: "IDLE"বার্তাটি প্রেরণ করে।
নিম্নলিখিত ডায়াগ্রামটি স্ট্যান্ডার্ড লাইভ ভয়েস সেশন এবং ব্যাকগ্রাউন্ড রিজনিং সহ থিঙ্কিং-এর মধ্যে ইন্টারঅ্যাকশন লাইফসাইকেলগুলির তুলনা করে:
সঠিক মডেল নির্বাচন করা
gemini-3.8-live এবং gemini-3.8-live-extended-thinking এর মধ্যে সিদ্ধান্ত নেওয়ার সময়, তিনটি প্রধান বিষয় বিবেচনা করুন: প্রতিক্রিয়ার বিলম্ব, কাজের জটিলতা এবং ক্লায়েন্টের অবস্থা পরিচালনা।
কখন Gemini 3.8 Live ব্যবহার করবেন
যেখানে তাৎক্ষণিক পালাবদল অপরিহার্য এবং কাজগুলো সরাসরি, সেখানে কম-লেটেন্সি সম্পন্ন কথোপকথনমূলক ভয়েস এজেন্টের জন্য gemini-3.8-live ব্যবহার করুন।
- কথোপকথনমূলক ভয়েস অ্যাসিস্ট্যান্ট : গ্রাহক পরিষেবা বাছাই, ভাষা অনুশীলন, ভয়েস সার্চ এবং ইন্টারেক্টিভ গল্প বলা।
- দ্রুত টুল সম্পাদন : এমন ওয়ার্কফ্লো যেখানে বাহ্যিক টুলগুলো মিলিসেকেন্ডের মধ্যে ফলাফল প্রদান করে (যেমন সেন্সরের মান পড়া বা স্মার্ট ডিভাইস নিয়ন্ত্রণ করা)।
- সরল ক্লায়েন্ট লজিক : এমন অ্যাপ্লিকেশন যেখানে ব্যবহারকারীর প্রতিটি পালা একটি একক মডেল প্রতিক্রিয়া গ্রহণ করে, এবং
turnComplete: trueনির্ভরযোগ্যভাবে সংকেত দেয় কখন সেশনটি নিষ্ক্রিয় থাকে।
কখন মিথুন ৩.৮ বর্ধিত চিন্তাভাবনা ব্যবহার করবেন
যখন আপনার এজেন্টকে জটিল ডেটা মূল্যায়ন করতে, একাধিক ধাপের পরিকল্পনা করতে, অথবা এমন টুল পরিচালনা করতে হয় যা চলতে কয়েক সেকেন্ড সময় নেয়, তখন gemini-3.8-live-extended-thinking ব্যবহার করুন।
- বহু-ধাপের ডায়াগনস্টিকস ও সাপোর্ট : টেকনিক্যাল সাপোর্ট এজেন্টরা একাধিক লগ, এরর কোড এবং কনফিগারেশন চেকের মাধ্যমে সিস্টেমের সমস্যা নির্ণয় করেন।
- সমন্বিত ডেটা পুনরুদ্ধার : ভ্রমণ এবং বুকিং এজেন্টরা সমান্তরাল এপিআই কলের মাধ্যমে ফ্লাইট অনুসন্ধান, হোটেল কোয়েরি এবং মূল্য তুলনা করতে পারেন।
- STEM ও কোড টিউটরিং : এমন শিক্ষামূলক এজেন্ট যারা কোনো ব্যাখ্যা বলার আগে সূত্র যাচাই করে, কোডের ত্রুটি সংশোধন করে, বা একাধিক ধাপের যুক্তি বিশ্লেষণ করে।
- মাস্কিং টুল ল্যাটেন্সি : এমন ভয়েস অভিজ্ঞতা যেখানে দীর্ঘক্ষণ ধরে চলা ফাংশনগুলো অন্যথায় শ্রোতার জন্য অস্বস্তিকর নীরবতা তৈরি করত।
মূল পার্থক্যগুলির সারাংশ
নিম্নলিখিত সারণিতে উভয় মডেলের মধ্যে প্রযুক্তিগত পার্থক্যগুলো সংক্ষেপে তুলে ধরা হলো:
| বৈশিষ্ট্য | জেমিনি ৩.৮ লাইভ | মিথুন ৩.৮ দীর্ঘ চিন্তাভাবনা নিয়ে বাঁচুন |
|---|---|---|
| প্রাথমিক ব্যবহারের ক্ষেত্রগুলি | কম-বিলম্বের ভয়েস এজেন্ট, সরাসরি কমান্ড, দ্রুত সরঞ্জাম | বহু-ধাপ সমস্যা সমাধান, জটিল পরিকল্পনা, বহু-সরঞ্জাম কর্মপ্রবাহ |
| মডেল এন্ডপয়েন্ট | gemini-3.8-live | gemini-3.8-live-extended-thinking |
| যুক্তি স্থাপত্য | নির্দিষ্ট লেটেন্সি প্রোফাইল সহ ইন্টারলিভড রিজনিং ( thinking_level সমর্থিত নয়) | কনফিগারযোগ্য পটভূমি যুক্তি ( thinking_level : low , medium , high ; MINIMAL সমর্থিত নয়) |
| সীমানা পরিবর্তন করুন | turnComplete: true টার্নটি শেষ করে এবং নিষ্ক্রিয় অবস্থায় ফিরে আসে। | turnComplete: true একটি উক্তি সমাপ্ত করে; interaction_status সেশনের জীবনচক্র নিয়ন্ত্রণ করে। |
| কথোপকথনের ফাঁক পূরণকারী | মডেলটি কথা বলার আগে টুলটি কার্যকর হওয়ার জন্য অপেক্ষা করে। | মডেলটি প্রক্রিয়াকরণের সময় কথোপকথনের মধ্যবর্তী শব্দাংশ প্রবাহিত করে। |
| টুল এক্সিকিউশন | সিঙ্ক্রোনাস ( BLOCKING ) এবং অ্যাসিঙ্ক্রোনাস ( NON_BLOCKING ) টুল সমর্থন করে | অ্যাসিঙ্ক্রোনাস ( NON_BLOCKING ) টুল ঘোষণার প্রয়োজন |
অভিবাসন এবং একীকরণের পথ
বিদ্যমান ভয়েস অ্যাপ্লিকেশনগুলি আপগ্রেড করতে অথবা আপনার লাইভ এপিআই সেশনগুলিতে থিঙ্কিং সংহত করতে এই পদক্ষেপগুলি অনুসরণ করুন।
জেমিনি ৩.১ ফ্ল্যাশ লাইভ থেকে আপগ্রেড করা হচ্ছে
gemini-3.1-flash-live-preview ব্যবহারকারী বিদ্যমান ভয়েস অ্যাপ্লিকেশনগুলির জন্য, gemini-3.8-live এ আপগ্রেড করতে হলে মডেল স্ট্রিং আপডেট করতে হবে এবং আপনার সেটআপ কনফিগারেশন থেকে thinking_level (বা thinking_config ) বাদ দিতে হবে, কারণ gemini-3.8-live এর জন্য thinking_level সমর্থিত নয়।
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
টার্ন লাইফসাইকেল এবং turnComplete সিগন্যালগুলো অভিন্ন থাকে।
চিন্তাভাবনা গ্রহণ করা
gemini-3.8-live-extended-thinking গ্রহণ করতে, তিনটি ইন্টিগ্রেশন পয়েন্ট আপডেট করুন:
turnCompleteএর পরিবর্তেinteraction_statusট্র্যাক করুন : Thinking সেশনগুলিতে, মডেলটি যুক্তি বিশ্লেষণের সময় মধ্যবর্তী কথোপকথনমূলক বার্তা পাঠাতে পারে। UI-এর অবস্থা পরিচালনা করতে আগত সার্ভার বার্তাগুলিরinteraction_statusফিল্ডটি পরীক্ষা করুন। শুধুমাত্র যখনinteraction_statusIDLEহবে, তখনই idle অবস্থায় ফিরে যান।পাইথন
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
জাভাস্ক্রিপ্ট
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
নন-ব্লকিং ফাংশন ঘোষণা করুন : সমস্ত ফাংশন ঘোষণায়
"behavior": "NON_BLOCKING"সেট করুন। থিঙ্কিং মডেলগুলো মৌখিক আপডেট স্ট্রিমিং করার সময় ব্যাকগ্রাউন্ডে অ্যাসিঙ্ক্রোনাসভাবে টুলগুলো চালায়। সিঙ্ক্রোনাস ব্লকিং টুলগুলো একটি ত্রুটি ফেরত দেয়।পাইথন
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
জাভাস্ক্রিপ্ট
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
যুক্তির গভীরতা নির্ধারণ করুন : যুক্তির স্তর (
low,mediumবাhigh;MINIMALসমর্থিত নয়) সামঞ্জস্য করতে আপনার সেশন কনফিগারেশনেthinking_configসেট করুন।পাইথন
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
জাভাস্ক্রিপ্ট
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
প্রোটোকল পাশাপাশি তুলনা
এই বিভাগে একটি লাইভ এপিআই সেশনের প্রতিটি পর্যায়ে আদান-প্রদান করা ওয়েবসকেট বার্তাগুলোর তুলনা করা হয়েছে।
ধাপ ১: সেশন সেটআপ
উভয় মডেল একই ওয়েবসকেট এন্ডপয়েন্টের সাথে সংযুক্ত হয়:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- অভিন্ন : ওয়েবসকেট ইউআরএল এবং এপিআই কী দ্বারা প্রমাণীকরণ।
- মডেল স্ট্রিং :
gemini-3.8-liveবনামgemini-3.8-live-extended-thinking. - চিন্তার কনফিগারেশন : যুক্তির গভীরতা সামঞ্জস্য করার জন্য ‘থিংকিং
thinkingConfigযুক্ত করা হয়েছে। টুলের আচরণ : চিন্তা করার জন্য ফাংশন ডিক্লারেশনে
"behavior": "NON_BLOCKING"প্রয়োজন।
জেমিনি ৩.৮ লাইভ
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
মিথুন ৩.৮ দীর্ঘ চিন্তাভাবনা নিয়ে বাঁচুন
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
সংযোগ স্থাপনের পর উভয় মডেলই একই সার্ভার স্বীকৃতি বার্তা পায়:
{
  "setupComplete": {}
}
ধাপ ২: ব্যবহারকারীর অডিও ইনপুট
উভয় মডেলেই অডিও স্ট্রিমিং একই রকম। realtimeInput ব্যবহার করে রিয়েল-টাইম ১৬kHz র PCM অডিও চাঙ্ক স্ট্রিম করা হয়।
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
ধাপ ৩: মডেলের প্রতিক্রিয়া এবং অবস্থার জীবনচক্র
উভয় মডেলই serverContent.modelTurn এ 24kHz PCM অডিও চাঙ্ক স্ট্রিম করে। তবে, লাইফসাইকেল ম্যানেজমেন্ট ভিন্ন:
জেমিনি ৩.৮ লাইভ প্রতিক্রিয়া প্রবাহ
- সার্ভারটি টার্নের জন্য অডিও খণ্ডাংশ স্ট্রিম করে।
- সার্ভার
turnComplete: trueপাঠায়, যা নির্দেশ করে যে মডেলটির কথা বলা শেষ হয়েছে এবং সেশনটি নিষ্ক্রিয় রয়েছে।
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
মিথুন ৩.৮ জীবন্ত বর্ধিত চিন্তার প্রতিক্রিয়া প্রবাহ
- কথ্য পূরক :
turnComplete: trueএবংinteractionStatus: "IN_PROGRESS"থাকলে মডেলটি মধ্যবর্তী বক্তব্য (যেমন "সিয়াটলের ফ্লাইট দেখছি..." ) নির্গত করে। - অ্যাসিঙ্ক্রোনাস টুল কল : যখন
interactionStatus"IN_PROGRESS"অবস্থায় থাকে, তখন সার্ভার টুল কলটি প্রেরণ করে, যা নির্দেশ করে যে সার্ভার সক্রিয়ভাবে বহু-ধাপের টার্নটি প্রক্রিয়া করছে এবং টুলের প্রতিক্রিয়ার জন্য অপেক্ষা করছে। - টুলের প্রতিক্রিয়া : ক্লায়েন্ট ফাংশনটি সম্পাদন করে এবং আউটপুট ফেরত দেয়।
- চূড়ান্ত প্রতিক্রিয়া : সার্ভার
turnComplete: trueএবংinteractionStatus: "IDLE"সহ সম্পূর্ণ উত্তরটি প্রদান করে।
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
SDK বাস্তবায়নের উদাহরণ
নিম্নলিখিত উদাহরণগুলিতে দেখানো হয়েছে কীভাবে Google GenAI SDK ব্যবহার করে Thinking কনফিগার করতে হয় এবং interaction_status পরিচালনা করতে হয়।
পাইথন
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
জাভাস্ক্রিপ্ট
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
এরপর কী?
- Gemini 3.8 Live এবং Gemini 3.8 Live Extended Thinking মডেলের পৃষ্ঠাগুলো পড়ুন।
- সমস্ত লাইভ এপিআই মডেল জুড়ে বৈশিষ্ট্যগুলির বিস্তারিত তুলনার জন্য মডেল তুলনা সারণীটি দেখুন।
- লাইভ এপিআই টুল ব্যবহার নির্দেশিকায় ফাংশন কলিং সম্পর্কে আরও জানুন।
- সেশন পুনরায় শুরু করা এবং কনটেক্সট লাইফসাইকেল পরিচালনা করার জন্য সেশন ম্যানেজমেন্ট পর্যালোচনা করুন।