

Interfejs Gemini Live API umożliwia dwukierunkowe rozmowy głosowe w czasie rzeczywistym z modelami Gemini.
Standardowe modele głosowe sprawdzają się w przypadku natychmiastowych rozmów. Mówisz do modelu, a on od razu generuje odpowiedź głosową. Gdy jednak prośba wymaga planowania, złożonej analizy lub narzędzi zewnętrznych, bezpośrednie odpowiedzi mają swoje ograniczenia. Model musi odpowiedzieć bez uzasadnienia lub wstrzymać się w ciszy, czekając na zakończenie działania narzędzi.
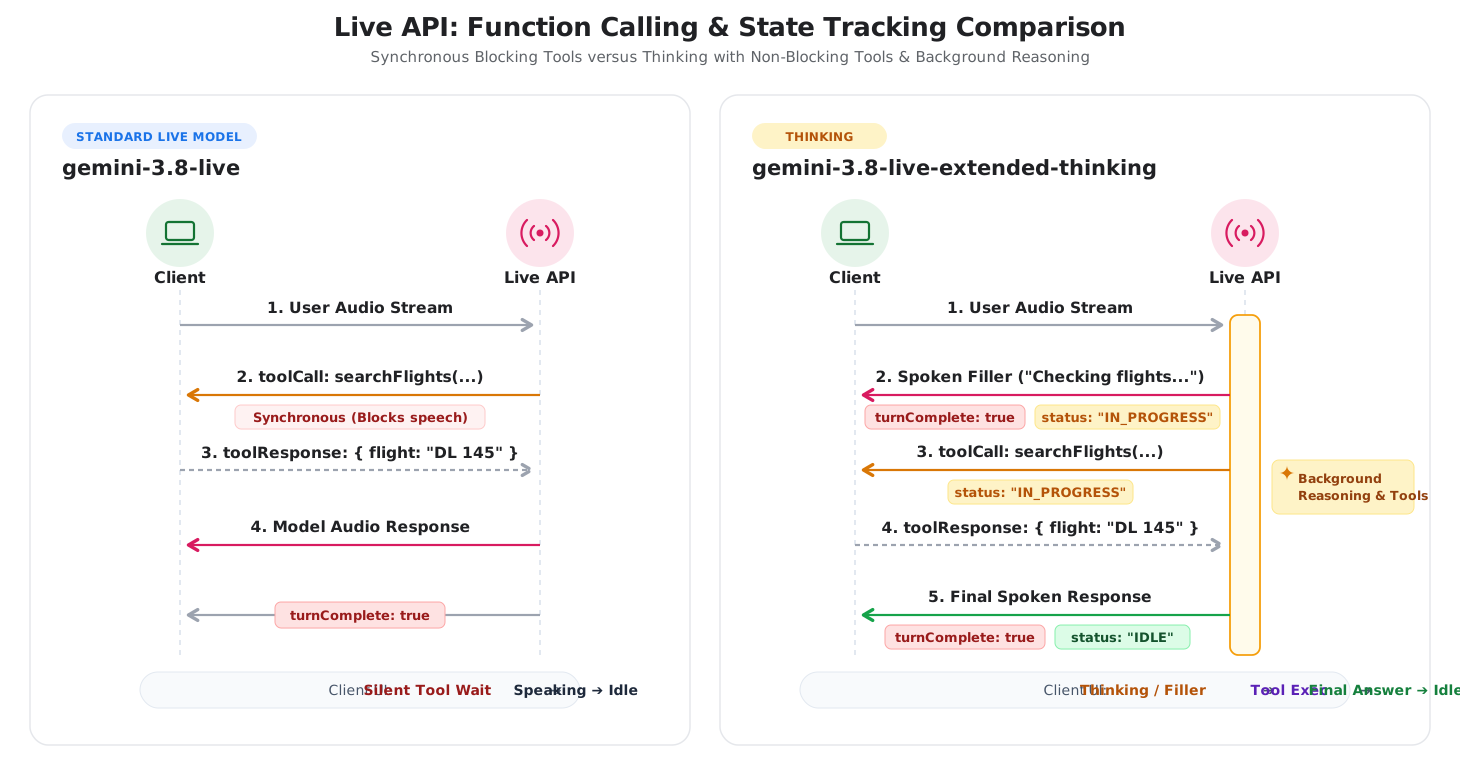
Funkcja Thinking in the Live API (gemini-3.8-live-extended-thinking) dodaje do sesji głosowych w czasie rzeczywistym uzasadnienie w tle. Model planuje i wywołuje asynchroniczne narzędzia w tle, mówiąc naturalne wypełniacze konwersacyjne, aby utrzymać aktywność interakcji.
Ta architektura zmienia cykl życia konwersacji na 2 główne sposoby:
- Wypełniacze konwersacyjne: model przekazuje aktualizacje pośrednie (np. „Sprawdzam teraz opcje lotu”) podczas wykonywania narzędzi w tle.
- Śledzenie stanu interakcji: ponieważ model może mówić wiele razy w ramach jednego żądania, serwer emituje sygnał
interaction_status: "IN_PROGRESS"podczas przetwarzania w tle i sygnałinteraction_status: "IDLE"po zakończeniu całego zadania.
Poniższy diagram porównuje cykle życia interakcji w przypadku standardowych sesji Live Voice i funkcji „Myślenie z uzasadnieniem w tle”:
Wybór odpowiedniego modelu
Przy wyborze między gemini-3.8-live a gemini-3.8-live-extended-thinking weź pod uwagę 3 główne kwestie: opóźnienie odpowiedzi, złożoność zadania i obsługę stanu klienta.
Kiedy korzystać z Gemini 3.8 Live
Używaj gemini-3.8-live w przypadku agentów głosowych o krótkim czasie oczekiwania, w których natychmiastowa zmiana kolejności jest niezbędna, a zadania są bezpośrednie.
- Konwersacyjni asystenci głosowi: wstępna obsługa klienta, ćwiczenie języka, wyszukiwanie głosowe i interaktywne opowiadanie historii.
- Szybkie wykonywanie narzędzi: przepływy pracy, w których narzędzia zewnętrzne zwracają wyniki w milisekundach (np. odczytywanie wartości z czujników lub sterowanie urządzeniami inteligentnymi).
- Prosta logika klienta: aplikacje, w których każda tura użytkownika otrzymuje jedną odpowiedź modelu, a
turnComplete: trueniezawodnie sygnalizuje, kiedy sesja jest nieaktywna.
Kiedy używać Gemini 3.8 Live z myśleniem rozszerzonym
Używaj gemini-3.8-live-extended-thinking, gdy agent musi ocenić złożone dane, zaplanować wiele kroków lub obsługiwać narzędzia, których uruchomienie zajmuje kilka sekund.
- Wieloetapowa diagnostyka i pomoc: pracownicy pomocy technicznej diagnozują problemy z systemem na podstawie wielu dzienników, kodów błędów i sprawdzania konfiguracji.
- Koordynowane pobieranie danych: agenci turystyczni i rezerwacyjni, którzy wyszukują loty, wysyłają zapytania o hotele i porównują ceny w równoległych wywołaniach interfejsu API.
- Korepetycje z nauk ścisłych i kodowania: agenci edukacyjni, którzy weryfikują formuły, debugują kod lub rozwiązują wieloetapowe problemy logiczne, zanim udzielą wyjaśnień.
- Opóźnienie narzędzia maskującego: doświadczenia głosowe, w których długotrwałe funkcje mogłyby w inny sposób powodować niezręczną ciszę dla słuchacza.
Podsumowanie najważniejszych różnic
W tej tabeli zestawiono różnice techniczne między tymi 2 modelami:
| Funkcja | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Główne przypadki użycia | Agenty głosowe o krótkim czasie oczekiwania, bezpośrednie polecenia, szybkie narzędzia | Rozwiązywanie problemów wieloetapowych, złożone planowanie, przepływy pracy z użyciem wielu narzędzi |
| Punkt końcowy modelu | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Architektura rozumowania | Przeplatane rozumowanie ze stałym profilem opóźnienia (thinking_level nieobsługiwany) |
Konfigurowane uzasadnienie w tle (thinking_level: low, medium, high; MINIMAL nie jest obsługiwane) |
| Granice skrętu | turnComplete: true kończy turę i wraca do stanu bezczynności. |
turnComplete: true kończy wypowiedź; interaction_status kontroluje cykl życia sesji |
| Wypełniacze w rozmowie | Model czeka na wykonanie narzędzia, zanim zacznie mówić | Model przesyła strumieniowo pośrednie wypełniacze konwersacyjne podczas przetwarzania |
| Uruchamianie narzędzia | Obsługuje narzędzia synchroniczne (BLOCKING) i asynchroniczne (NON_BLOCKING). |
Wymaga asynchronicznych deklaracji narzędzi (NON_BLOCKING) |
Ścieżki migracji i integracji
Aby uaktualnić istniejące aplikacje głosowe lub zintegrować funkcję Thinking z sesjami interfejsu Live API, wykonaj te czynności.
Uaktualnianie z Gemini 3.1 Flash Live
W przypadku istniejących aplikacji głosowych korzystających z gemini-3.1-flash-live-preview przejście na gemini-3.8-live wymaga zaktualizowania ciągu modelu i pominięcia thinking_level (lub thinking_config) w konfiguracji, ponieważ thinking_level nie jest obsługiwany w przypadku gemini-3.8-live:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Cykl życia tury i sygnały turnComplete pozostają identyczne.
Przyjmowanie myślenia
Aby wdrożyć gemini-3.8-live-extended-thinking, zaktualizuj 3 punkty integracji:
Śledzenie
interaction_statuszamiastturnComplete: podczas sesji „Myślenie” model może emitować pośrednie wypełniacze konwersacyjne podczas rozumowania. Sprawdzaj poleinteraction_statusw przychodzących wiadomościach z serwera, aby zarządzać stanem interfejsu. Wracaj do stanu bezczynności tylko wtedy, gdyinteraction_statusma wartośćIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Deklarowanie funkcji nieblokujących: ustaw wartość
"behavior": "NON_BLOCKING"we wszystkich deklaracjach funkcji. Modele myślowe uruchamiają narzędzia asynchronicznie w tle, przesyłając strumieniowo aktualizacje głosowe. Narzędzia blokujące synchronicznie zwracają błąd.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Skonfiguruj głębokość rozumowania: ustaw
thinking_configw konfiguracji sesji, aby dostosować poziomy rozumowania (low,mediumlubhigh;MINIMALnie jest obsługiwany).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Porównanie protokołów
W tej sekcji porównujemy wiadomości WebSocket wymieniane w poszczególnych fazach sesji interfejsu Live API.
Krok 1. Konfiguracja sesji
Oba modele łączą się z tym samym punktem końcowym WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Identyczne: adres URL WebSocket i uwierzytelnianie kluczem interfejsu API.
- Ciąg modelu:
gemini-3.8-liveversusgemini-3.8-live-extended-thinking. - Konfiguracja myślenia: myślenie dodaje
thinkingConfig, aby dostosować głębię rozumowania. Działanie narzędzia: myślenie wymaga
"behavior": "NON_BLOCKING"w deklaracjach funkcji.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Po nawiązaniu połączenia oba modele otrzymują to samo potwierdzenie serwera:
{
  "setupComplete": {}
}
Krok 2. Dane wejściowe audio użytkownika
Strumieniowanie dźwięku jest identyczne w przypadku obu modeli. Bloki surowego dźwięku PCM o częstotliwości próbkowania 16 kHz w czasie rzeczywistym są przesyłane strumieniowo za pomocą metody realtimeInput:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Krok 3. Odpowiedź modelu i cykl życia stanu
Oba modele przesyłają strumieniowo fragmenty audio PCM o częstotliwości próbkowania 24 kHz w serverContent.modelTurn. Jednak zarządzanie cyklem życia różni się w tych przypadkach:
Przebieg odpowiedzi Gemini 3.8 Live
- Serwer przesyła strumieniowo fragmenty dźwięku dla danej tury.
- Serwer wysyła
turnComplete: true, co oznacza, że model skończył mówić i sesja jest bezczynna.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Przebieg odpowiedzi Gemini 3.8 Live Extended Thinking
- Wypełniacz mowy: model emituje pośrednią mowę (np. „Sprawdzam loty do Seattle…”) z
turnComplete: trueiinteractionStatus: "IN_PROGRESS". - Asynchroniczne wywołanie narzędzia: serwer emituje wywołanie narzędzia, a
interactionStatuspozostaje"IN_PROGRESS", co oznacza, że serwer aktywnie przetwarza wieloetapową turę i czeka na odpowiedź narzędzia. - Odpowiedź narzędzia: klient wykonuje funkcję i zwraca dane wyjściowe.
- Odpowiedź końcowa: serwer przesyła pełną odpowiedź z elementami
turnComplete: trueiinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Przykłady implementacji pakietu SDK
Z przykładów poniżej dowiesz się, jak skonfigurować funkcję Thinking i obsługiwać interaction_status za pomocą pakietu Google GenAI SDK.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Co dalej?
- Przeczytaj strony modeli Gemini 3.8 Live i Gemini 3.8 Live z myśleniem rozszerzonym.
- Szczegółowe porównanie funkcji wszystkich modeli interfejsu Live API znajdziesz w tabeli Porównanie modeli.
- Więcej informacji o wywoływaniu funkcji znajdziesz w przewodniku Korzystanie z narzędzia Live API Tool.
- Zapoznaj się z sekcją Zarządzanie sesją, aby dowiedzieć się, jak obsługiwać wznawianie sesji i cykl życia kontekstu.