

Gemini Live API cho phép trò chuyện hai chiều bằng giọng nói theo thời gian thực với các mô hình Gemini.
Các mô hình giọng nói tiêu chuẩn hoạt động hiệu quả đối với cuộc trò chuyện qua lại tức thì. Bạn nói với mô hình và mô hình sẽ tạo ra câu trả lời bằng lời nói ngay lập tức. Nhưng khi một yêu cầu cần có kế hoạch, phân tích phức tạp hoặc các công cụ bên ngoài, câu trả lời trực tiếp sẽ bị giới hạn. Mô hình phải trả lời mà không cần suy luận hoặc tạm dừng trong im lặng trong khi chờ các công cụ hoàn tất.
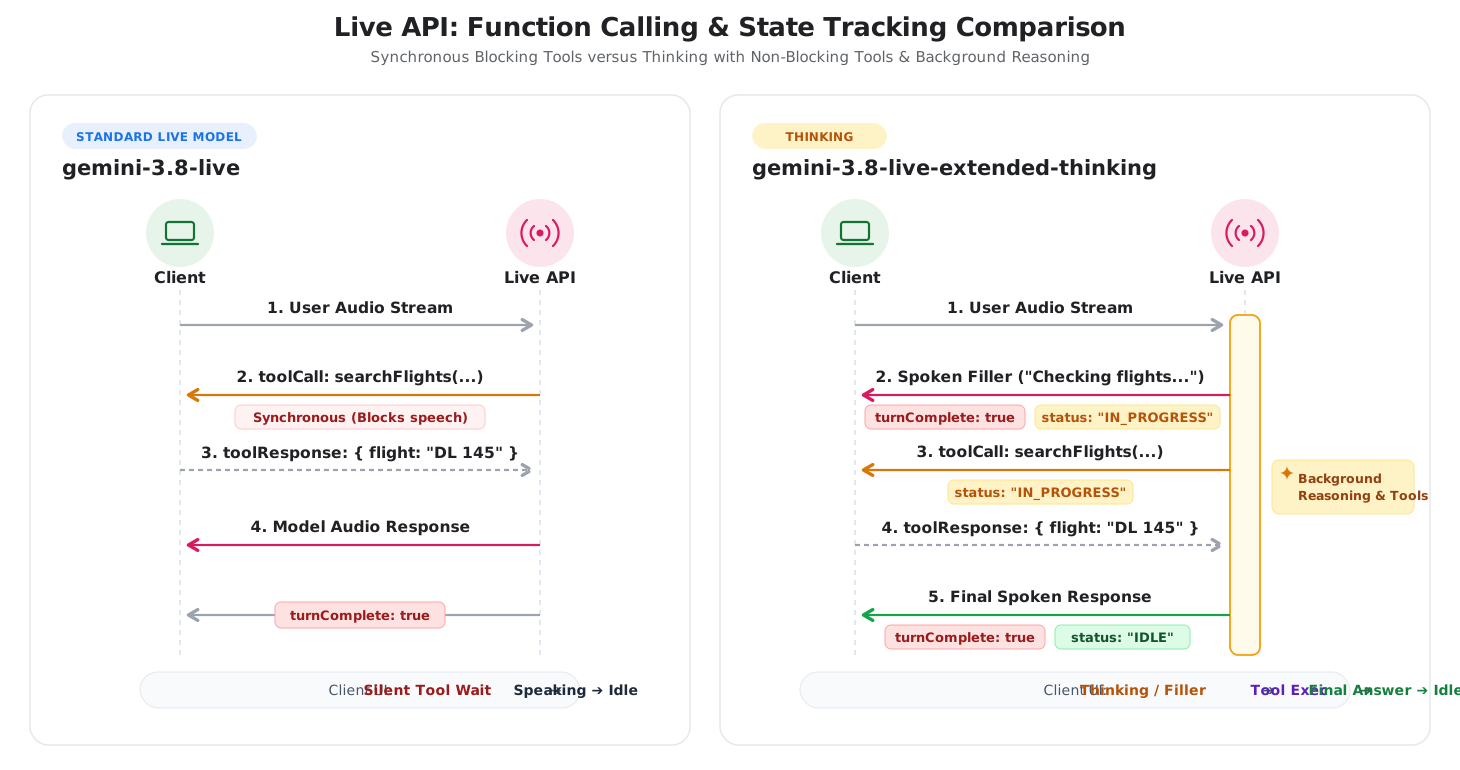
Tính năng Tư duy trong Live API (gemini-3.8-live-extended-thinking) bổ sung khả năng suy luận nền cho các phiên trò chuyện bằng giọng nói theo thời gian thực. Mô hình này lên kế hoạch và gọi các công cụ không đồng bộ ở chế độ nền trong khi nói các từ đệm tự nhiên để duy trì hoạt động tương tác.
Cấu trúc này thay đổi vòng đời của cuộc trò chuyện theo hai cách chính:
- Từ đệm: Mô hình sẽ nói các thông tin cập nhật trung gian (chẳng hạn như "Đang kiểm tra các lựa chọn về chuyến bay") trong khi thực hiện các công cụ ở chế độ nền.
- Theo dõi trạng thái tương tác: Vì mô hình có thể nói nhiều lần trong một yêu cầu, nên máy chủ sẽ phát ra
interaction_status: "IN_PROGRESS"trong quá trình xử lý ở chế độ nền vàinteraction_status: "IDLE"khi hoàn thành nhiệm vụ tổng thể.
Sơ đồ sau đây so sánh vòng đời tương tác giữa các phiên Livevoice tiêu chuẩn và tính năng Tư duy bằng lý luận nền:
Chọn mô hình phù hợp
Khi quyết định giữa gemini-3.8-live và gemini-3.8-live-extended-thinking, hãy cân nhắc 3 yếu tố chính: độ trễ phản hồi, độ phức tạp của tác vụ và việc xử lý trạng thái của ứng dụng.
Khi nào nên sử dụng Gemini 3.8 Live
Sử dụng gemini-3.8-live cho các tác nhân giọng nói đàm thoại có độ trễ thấp, trong đó việc chuyển lượt ngay lập tức là điều cần thiết và các tác vụ là trực tiếp.
- Trợ lý đàm thoại bằng giọng nói: Phân loại dịch vụ khách hàng, luyện tập ngôn ngữ, tìm kiếm bằng giọng nói và kể chuyện tương tác.
- Thực thi công cụ nhanh: Quy trình làm việc mà các công cụ bên ngoài trả về trong vòng mili giây (chẳng hạn như đọc các giá trị cảm biến hoặc điều khiển các thiết bị thông minh).
- Logic đơn giản của ứng dụng: Các ứng dụng mà mỗi lượt tương tác của người dùng nhận được một phản hồi duy nhất của mô hình và
turnComplete: truebáo hiệu một cách đáng tin cậy khi phiên không hoạt động.
Khi nào nên sử dụng Gemini 3.8 Live có chế độ Tư duy mở rộng
Sử dụng gemini-3.8-live-extended-thinking khi tác nhân của bạn phải đánh giá dữ liệu phức tạp, lên kế hoạch cho nhiều bước hoặc xử lý các công cụ mất vài giây để chạy.
- Hỗ trợ và chẩn đoán nhiều bước: Nhân viên hỗ trợ kỹ thuật chẩn đoán các vấn đề về hệ thống trên nhiều nhật ký, mã lỗi và quy trình kiểm tra cấu hình.
- Truy xuất dữ liệu phối hợp: Đại lý du lịch và đặt vé tìm kiếm chuyến bay, truy vấn khách sạn và so sánh giá trên các lệnh gọi API song song.
- Dạy kèm về STEM và lập trình: Các đặc vụ giáo dục xác minh công thức, gỡ lỗi mã hoặc thực hiện logic nhiều bước trước khi giải thích.
- Độ trễ của công cụ che giấu: Trải nghiệm bằng giọng nói mà các hàm chạy trong thời gian dài sẽ tạo ra sự im lặng khó xử cho người nghe.
Tóm tắt những điểm khác biệt chính
Bảng sau đây tóm tắt những điểm khác biệt về kỹ thuật giữa cả hai mô hình:
| Tính năng | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Các trường hợp sử dụng chính | Tác nhân thoại có độ trễ thấp, lệnh trực tiếp, công cụ nhanh | Giải quyết vấn đề nhiều bước, lập kế hoạch phức tạp, quy trình làm việc nhiều công cụ |
| Điểm cuối của mô hình | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Cấu trúc suy luận | Lý luận xen kẽ với hồ sơ độ trễ cố định (không hỗ trợ thinking_level) |
Lý do có thể định cấu hình ở chế độ nền (thinking_level: low, medium, high; không hỗ trợ MINIMAL) |
| Bật ranh giới | turnComplete: true đóng lượt và quay về trạng thái chờ |
turnComplete: true kết thúc một câu nói; interaction_status kiểm soát vòng đời của phiên |
| Từ đệm trong cuộc trò chuyện | Mô hình chờ thực thi công cụ trước khi nói | Mô hình này mô phỏng các từ đệm trong cuộc trò chuyện trong khi xử lý |
| Thực thi công cụ | Hỗ trợ các công cụ đồng bộ (BLOCKING) và không đồng bộ (NON_BLOCKING) |
Yêu cầu khai báo công cụ không đồng bộ (NON_BLOCKING) |
Các phương pháp di chuyển và tích hợp
Hãy làm theo các bước sau để nâng cấp các ứng dụng thoại hiện có hoặc tích hợp Thinking vào các phiên Live API.
Nâng cấp từ Gemini 3.1 Flash Live
Đối với các ứng dụng giọng nói hiện có đang dùng gemini-3.1-flash-live-preview, việc nâng cấp lên gemini-3.8-live yêu cầu bạn phải cập nhật chuỗi mô hình và bỏ qua thinking_level (hoặc thinking_config) trong cấu hình thiết lập, vì gemini-3.8-live không được hỗ trợ thinking_level:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Vòng đời lượt và tín hiệu turnComplete vẫn giữ nguyên.
Tư duy thích ứng
Để áp dụng gemini-3.8-live-extended-thinking, hãy cập nhật 3 điểm tích hợp:
Theo dõi
interaction_statusthay vìturnComplete: Trong các phiên Tư duy, mô hình có thể đưa ra các từ nối hội thoại trung gian trong khi suy luận. Kiểm tra trườnginteraction_statustrong các thông báo đến từ máy chủ để quản lý trạng thái giao diện người dùng. Chỉ chuyển về trạng thái rảnh khiinteraction_statuslàIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Khai báo các hàm không chặn: Đặt
"behavior": "NON_BLOCKING"trên tất cả các nội dung khai báo hàm. Các mô hình tư duy chạy các công cụ không đồng bộ ở chế độ nền trong khi truyền trực tuyến các thông tin cập nhật bằng lời nói. Các công cụ chặn đồng bộ sẽ trả về một lỗi.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Định cấu hình độ sâu suy luận: Đặt
thinking_configtrong cấu hình phiên để điều chỉnh các cấp độ suy luận (low,mediumhoặchigh; không hỗ trợMINIMAL).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
So sánh song song giao thức
Phần này so sánh các thông báo WebSocket được trao đổi trong mỗi giai đoạn của một phiên Live API.
Bước 1: Thiết lập phiên
Cả hai mô hình đều kết nối với cùng một điểm cuối WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Giống nhau: Xác thực khoá API và URL WebSocket.
- Chuỗi mô hình:
gemini-3.8-liveso vớigemini-3.8-live-extended-thinking. - Cấu hình tư duy: Tư duy thêm
thinkingConfigđể điều chỉnh độ sâu lý luận. Hành vi của công cụ: Để suy nghĩ, bạn cần
"behavior": "NON_BLOCKING"về các khai báo hàm.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Cả hai mô hình đều nhận được thông báo xác nhận của máy chủ khi kết nối:
{
  "setupComplete": {}
}
Bước 2: Đầu vào âm thanh của người dùng
Tính năng phát trực tuyến âm thanh giống nhau ở cả hai mẫu. Các đoạn âm thanh PCM thô 16 kHz theo thời gian thực được truyền trực tuyến bằng realtimeInput:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Bước 3: Vòng đời của trạng thái và phản hồi mô hình
Cả hai mô hình đều truyền các đoạn âm thanh PCM 24 kHz trong serverContent.modelTurn. Tuy nhiên, việc quản lý vòng đời có sự khác biệt:
Luồng phản hồi trực tiếp của Gemini 3.8
- Máy chủ truyền trực tuyến các đoạn âm thanh cho lượt trò chuyện.
- Máy chủ gửi
turnComplete: true, cho biết mô hình đã nói xong và phiên đang ở trạng thái rảnh.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Luồng phản hồi Tư duy mở rộng của Gemini 3.8 Live
- Từ nối: Mô hình phát ra lời nói trung gian (chẳng hạn như "Đang kiểm tra các chuyến bay đến Seattle...") bằng
turnComplete: truevàinteractionStatus: "IN_PROGRESS". - Lệnh gọi công cụ không đồng bộ: Máy chủ phát ra lệnh gọi công cụ trong khi
interactionStatusvẫn là"IN_PROGRESS", cho biết rằng máy chủ đang tích cực xử lý lượt nhiều bước và chờ phản hồi của công cụ. - Phản hồi của công cụ: Máy khách thực thi hàm và trả về đầu ra.
- Phản hồi cuối cùng: Máy chủ cung cấp câu trả lời hoàn chỉnh bằng
turnComplete: truevàinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Ví dụ về cách triển khai SDK
Các ví dụ sau đây cho thấy cách định cấu hình Thinking và xử lý interaction_status bằng Google GenAI SDK.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Bước tiếp theo
- Đọc các trang về mô hình Gemini 3.8 Live và Gemini 3.8 Live có chế độ Tư duy mở rộng.
- Hãy xem bảng So sánh mô hình để biết thông tin so sánh chi tiết về các tính năng của tất cả các mô hình Live API.
- Tìm hiểu thêm về tính năng gọi hàm trong hướng dẫn Sử dụng công cụ Live API.
- Xem lại phần Quản lý phiên để xử lý việc tiếp tục phiên và vòng đời của bối cảnh.