

מודלים של Gemini Robotics ER (חשיבה רציונלית מגולמת) הם מודלים של ראייה ושפה (VLM) שמאפשרים לרובוטים לתפוס את העולם הפיזי ולתקשר איתו. הם מפרשים נתונים חזותיים, מבצעים חשיבה מרחבית וזמנית, מתכננים משימות מרובות שלבים ומתזמרים רובוטים וכלים.
מודלים
Gemini Robotics ER 2 הוא המודל הכי עדכני של Gemini Robotics. זהו מודל החשיבה הרציונלית המעודכן שלנו, שמאפשר לרובוטים להבין את הסביבה שלהם בצורה מדויקת. הוא מתמחה ביכולות חשיבה מגולמת, כמו תזמור סוכנים של רובוטים (למשל, באמצעות VLA), הבנת וידאו של רובוטים, כולל הבנת ההתקדמות וזיהוי הצלחה, קריאת מכשירים, הצבעה וחשיבה מרחבית.
במודל Gemini Robotics ER 2 יש שתי נקודות קצה:
-
gemini-robotics-er-2-preview: המודל הרגיל של ER 2. הוא מבוסס על Gemini 3.5 Flash, עם יכולות משופרות של חשיבה מרחבית, איתור רגעים בסרטונים, סיווג התקדמות בסרטונים, תזמור של כמה רובוטים ושימוש בכלים בכמה שלבים. -
gemini-robotics-er-2-streaming-preview: מודל שמותאם לסטרימינג בזמן אמת באמצעות Live API. המודל הזה מתאים לסוכני רובוט עם זמן אחזור קצר שמעבדים קלט אודיו ווידאו רציף.
גרסה Gemini Robotics ER 1.6 הוצאה משימוש ב-31 באוגוסט 2026.
אם אתם עדיין משתמשים ב-Gemini Robotics ER 1.6, אתם צריכים לשדרג ל-Gemini Robotics ER 2. כדי לעשות את זה, החליפו את model="gemini-robotics-er-1.6-preview" ב-model="gemini-robotics-er-2-preview" או ב-model="gemini-robotics-er-2-streaming-preview" בקריאות ל-API.
איך מנסים את Gemini Robotics ER 2 ב-Google AI Studio
יכולות רובוטיקה
Gemini Robotics ER תומך במגוון יכולות של הסקת מסקנות מבוססת-גוף. כדי לקבל מידע נוסף, בחרו יכולת:
| פונקציה | תיאור | הדרכות |
|---|---|---|
| חשיבה מרחבית | להצביע על אובייקטים, לעקוב אחריהם בסרטון, לזהות אותם באמצעות תיבות תוחמות (bounding box) ולתכנן מסלולים. | חשיבה מרחבית |
| ראייה מבוססת-סוכנים | להשתמש בהפעלת קוד כדי לשפר יכולות אחרות באמצעות כלים לעריכת תמונות. | ראייה אג'נטית |
| תזמור משימות | לשלב חשיבה מרחבית עם ממשקי API מותאמים אישית לרובוטים כדי להשלים משימות ארוכות טווח. | תזמור משימות |
| סטרימינג (רק בנקודת הקצה של Gemini Robotics ER 2 Streaming) | סטרימינג דו-כיווני לסוכני רובוט בזמן אמת עם קריאה להפעלת פונקציות בזמן אחזור קצר. | סטרימינג לרובוטיקה |
| התקדמות הסרטון (רק ב-Gemini Robotics ER 2) | איתור רגעים וסיווג התקדמות מפידים של סרטונים רציפים. | הבנת סרטונים |
לפני שמתחילים
המודלים של Gemini Robotics ER זמינים דרך Gemini Developer API. כדי להתחיל, יוצרים מפתח Gemini API מ-Google AI Studio או ממסוף Google Cloud, ומגדירים את הסביבה.
במאמר שימוש במפתחות Gemini API מוסבר על סוגי מפתחות ה-API, האבטחה ואיך להגדיר את מפתח ה-API ב-Python, ב-JavaScript ובשפות אחרות.
תחילת העבודה
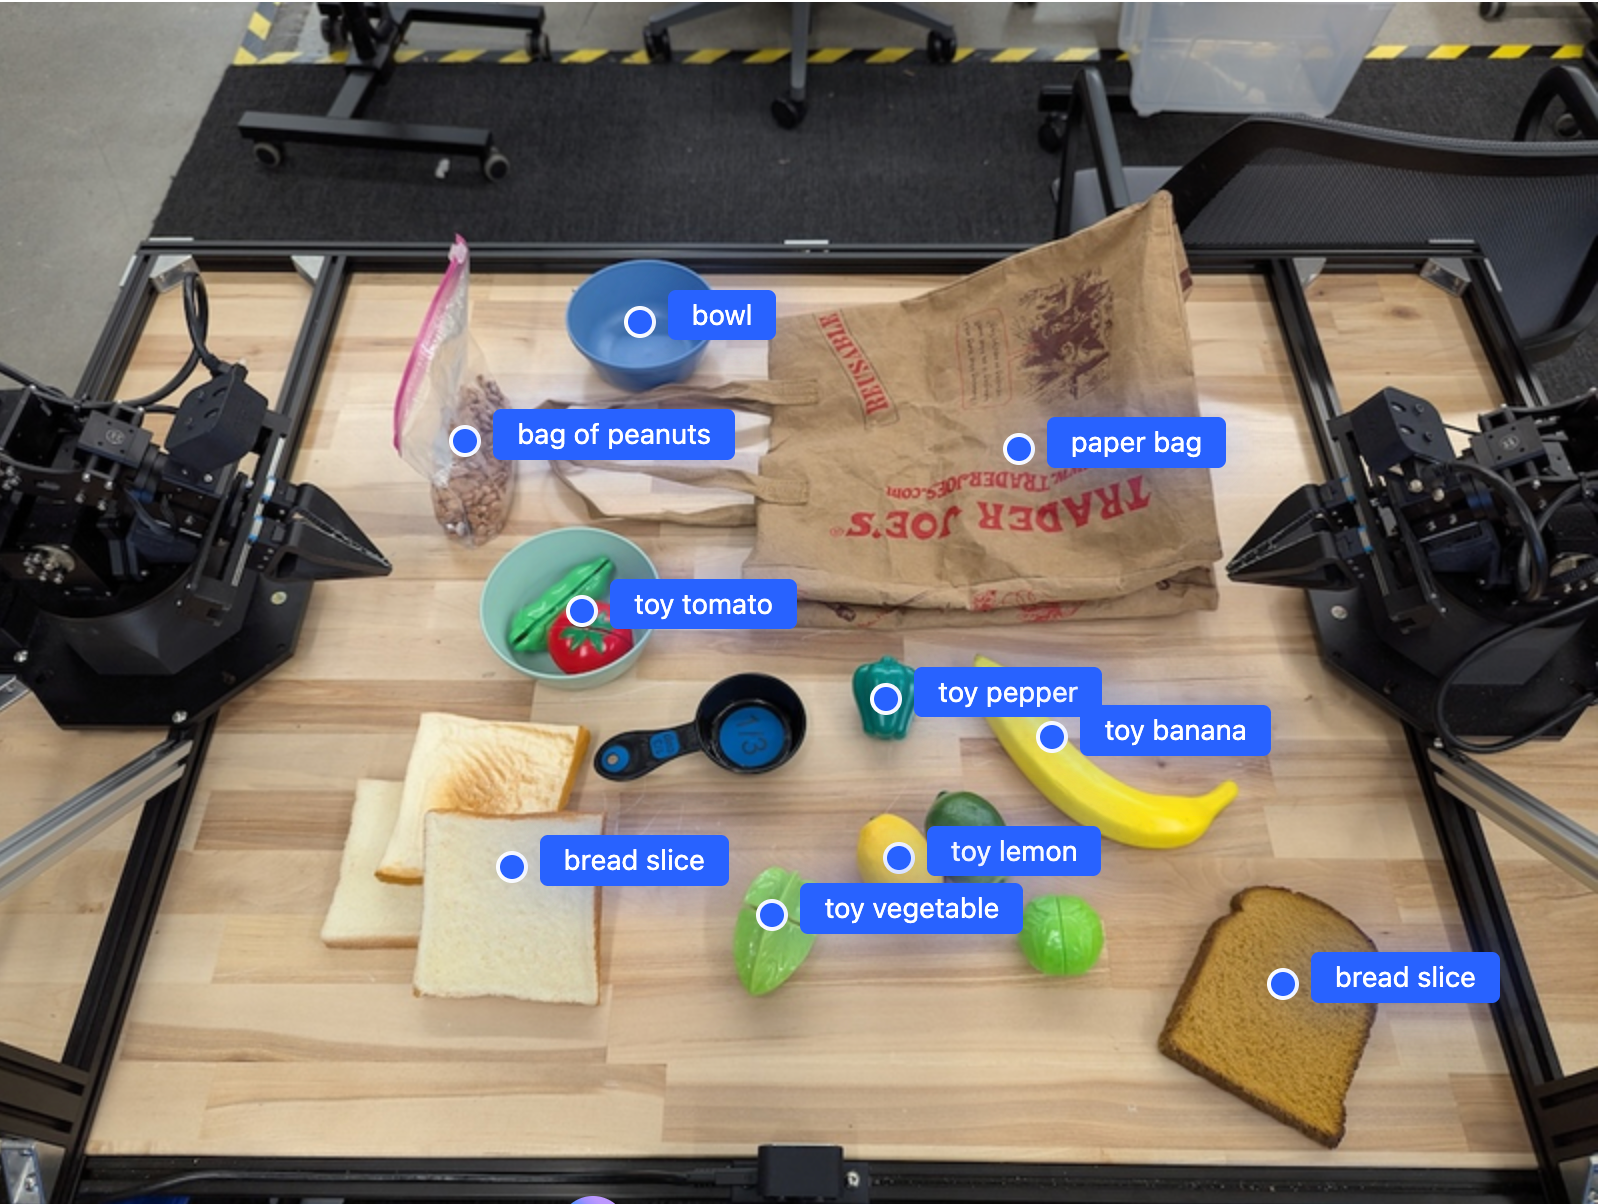
בדוגמה הבאה, המערכת מוצאת אובייקטים בתמונה ומחזירה את הקואורדינטות הדו-ממדיות המנורמלות ואת התוויות שלהם. אתם יכולים להעביר את הפלט הזה ישירות ל-API של רובוטיקה או למודל VLA כדי ליצור פעולות של רובוט.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
הפלט יהיה מערך JSON שמכיל אובייקטים, כל אחד עם point (קואורדינטות [y, x] מנורמלות) ו-label שמזהה את האובייקט.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
בתמונה הבאה מוצגת דוגמה לאופן שבו הנקודות האלה יכולות להופיע:
איך זה עובד
Gemini Robotics ER מקבל קלט של תמונות, סרטונים או אודיו עם הנחיות בשפה טבעית. הוא מזהה אובייקטים, מסיק מסקנות לגבי ההקשר של הסצנה והיחסים המרחביים, ומחזיר פלט מובנה כמו קואורדינטות או תיבות תוחמות (bounding box).
Gemini Robotics ER הוא גם סוכן: הוא מפרק משימות מורכבות לתת-משימות ומבצע אותן על ידי קריאה לפונקציות של הרובוט או הפעלת קוד שנוצר. לדוגמה, "שים את התפוח בקערה" הופך לרצף של שלבי איתור, אחיזה והנחה.
במאמר קריאה לפונקציות מוסבר איך Gemini מפעיל כלים.
בטיחות
למרות ש-Gemini Robotics ER פותח תוך התחשבות בבטיחות, אתם אחראים לשמור על סביבה בטוחה סביב הרובוט. מודלים של AI גנרטיבי עלולים לטעות, ורובוטים פיזיים עלולים לגרום נזק. מידע נוסף זמין בדף הבטיחות של Gemini Robotics.
שיטות מומלצות
השתמשו בשפה פשוטה וטבעית. תארו מה אתם רוצים שהרובוט יעשה, כמו שהייתם מסבירים לאדם. אם מונח מסוים לא עובד, נסו מילה נרדפת נפוצה.
אופטימיזציה של הקלט החזותי. לפני ששולחים את התמונה, חותכים אותה או מתקרבים לאובייקטים קטנים או לא ברורים. תאורה וניגודיות צבעים נמוכה יכולות להשפיע על הזיהוי.
לפצל משימות מורכבות לשלבים. כדי שהמודל יישאר ממוקד ויספק תשובות מדויקות יותר, שלחו כל שלב כהנחיה נפרדת.
למשימות שדורשות דיוק גבוה, כדאי לשלוח שאילתות כמה פעמים ולחשב את ממוצע התוצאות. הגישה הזו, שמבוססת על קונצנזוס, מצמצמת את השונות בפלטים המרחביים.
מגבלות
כשמפתחים עם Gemini Robotics ER, חשוב להביא בחשבון את המגבלות הבאות:
- הגבלות על מפתחות API: Gemini API לא מקבל בקשות ממפתחות API לא מוגבלים ומחזיר שגיאה מסוג
403 Forbidden. כדי לאבטח את מפתח ה-API, מוסיפים הגבלות ב-AI Studio. פרטים נוספים זמינים במאמר אבטחת מפתחות API לא מוגבלים. - זמן אחזור לעומת ביצועים: שאילתות מורכבות, קלט ברזולוציה גבוהה או רמות חשיבה גבוהות יכולים להאריך את זמני העיבוד. כדי לקבל איזון טוב בין זמן האחזור לביצועים, כדאי להגדיר את רמת החשיבה ל"בינונית".
- הזיות: כמו כל המודלים הגדולים של שפה (LLM), המודלים של Gemini Robotics ER עלולים לפעמים "להזות" או לספק מידע שגוי, במיוחד בתגובה להנחיות לא ברורות או לקלט שלא תואם להתפלגות הנתונים.
- תלות באיכות ההנחיה: איכות הפלט תלויה בבהירות של ההנחיה שהוזנה. השתמשו בהנחיות ספציפיות ומובנות היטב.
- עלות החישוב: הפעלת המודל, במיוחד עם קלט וידאו או ערך
thinking_budgetגבוה, צורכת משאבי מחשוב וגורמת לעלויות. פרטים נוספים זמינים בדף חשיבה. - סוגי קלט: בנושאים הבאים מפורטות המגבלות של כל מצב.
הודעת פרטיות
אתם מאשרים שהמודלים שמוזכרים במסמך הזה ("המודלים הרובוטיים") משתמשים בנתוני וידאו ואודיו כדי להפעיל ולהזיז את החומרה שלכם בהתאם להוראות שלכם. לכן, יכול להיות שתפעילו את המודלים לרובוטיקה כך שהם יאספו נתונים מאנשים שניתן לזהות, כמו נתוני קול, תמונות ודמיון ("מידע אישי"). אם בחרת להפעיל את המודלים לרובוטיקה באופן שבו נאסף מידע אישי, הסכמת שלא לאפשר לאנשים שניתן לזהות אותם ליצור אינטראקציה עם המודלים לרובוטיקה או להיות נוכחים באזור שסביבם, אלא אם האנשים האלה קיבלו הודעה מספקת על כך שהמידע האישי שלהם עשוי להימסר ל-Google ולשמש אותה, והסכימו לכך, כפי שמפורט בתנאים ובהגבלות הנוספים של Gemini API בכתובת https://ai.google.dev/gemini-api/terms ("התנאים"), כולל בהתאם לסעיף "איך Google משתמשת בנתונים שלך". עליך לוודא שההודעה הזו מאפשרת את האיסוף של מידע אישי ואת השימוש בו כפי שמתואר בתנאים, ולהשתמש במאמצים סבירים מבחינה מסחרית כדי לצמצם את האיסוף וההפצה של מידע אישי באמצעות טכניקות כמו טשטוש פנים והפעלת המודלים הרובוטיים באזורים שלא מכילים אנשים שניתן לזהות, ככל שניתן.
תמחור
למידע מפורט על התמחור והאזורים הזמינים, עיינו בדף התמחור.
נקודות קצה של מודלים
Gemini Robotics ER 2 Preview
| נכס | תיאור |
|---|---|
| קוד המודל | gemini-robotics-er-2-preview |
| סוגי נתונים נתמכים |
הנחיות טקסט, תמונות, וידאו, אודיו פלט טקסט |
| מגבלות על אסימונים[*] |
מגבלת טוקנים בקלט 131,072 מגבלת טוקנים בפלט 65,536 |
| יכולות | לא נתמך נתמך נתמך נתמך נתמך נתמך נתמך לא נתמך לא נתמך נתמך נתמך נתמך נתמך |
| אפשרויות צריכה |
נתמך לא נתמך לא נתמך |
| גרסאות |
|
| העדכון האחרון | יולי 2026 |
| כרטיס מודל | כרטיס מודל |
Gemini Robotics ER 2 Streaming Preview
| נכס | תיאור |
|---|---|
| קוד המודל | gemini-robotics-er-2-streaming-preview |
| סוגי נתונים נתמכים |
הנחיות טקסט, תמונות, וידאו, אודיו פלט טקסט |
| מגבלות על אסימונים[*] |
מגבלת טוקנים בקלט 131,072 מגבלת טוקנים בפלט 65,536 |
| יכולות | לא נתמך לא נתמך לא נתמך לא נתמך לא נתמך נתמך לא נתמך לא נתמך נתמך נתמך לא נתמך נתמך לא נתמך |
| אפשרויות צריכה |
לא נתמך לא נתמך לא נתמך |
| גרסאות |
|
| העדכון האחרון | יולי 2026 |
| כרטיס מודל | כרטיס מודל |
Gemini Robotics ER 1.6 Preview
| נכס | תיאור |
|---|---|
| קוד המודל | gemini-robotics-er-1.6-preview |
| סוגי נתונים נתמכים |
הנחיות טקסט, תמונות, וידאו, אודיו פלט טקסט |
| מגבלות על אסימונים[*] |
מגבלת טוקנים בקלט 131,072 מגבלת טוקנים בפלט 65,536 |
| יכולות | לא נתמך נתמך נתמך נתמך נתמך נתמך נתמך לא נתמך לא נתמך נתמך נתמך נתמך נתמך |
| אפשרויות צריכה |
נתמך לא נתמך לא נתמך |
| גרסאות |
|
| העדכון האחרון | דצמבר 2025 |
| תאריך סף הידע | ינואר 2025 |
המאמרים הבאים
- חשיבה מרחבית – הצבעה, מעקב, תיבות תוחמות, מסלולים.
- יכולות אג'נטיות – הרצת קוד, קריאת מכשירים, הוספת הערות לתמונות.
- תזמור משימות – משימות ארוכות טווח עם ממשקי API מותאמים אישית לרובוטים.
- רובוטיקה עם סטרימינג – סטרימינג דו-כיווני בזמן אמת (רק ב-Gemini Robotics ER 2).
- הבנת סרטונים – איתור רגעים וסיווג התקדמות (רק ב-Gemini Robotics ER 2).
- בטיחות ב-Gemini Robotics – מחקר בטיחות שקשור למשפחת המודלים.