

Replikacja głosu umożliwia odtworzenie charakterystyki głosu mówcy na podstawie krótkiej próbki audio za pomocą punktu końcowego Gemini API Voices (POST /v1beta/voices). Replikacja głosu jest obsługiwana zarówno przez Gemini 3.8 Flash TTS (gemini-3.8-flash-tts), jak i Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts).
Najszybszym sposobem na skopiowanie, sprawdzenie zgody i przesłuchanie skopiowanego głosu jest interaktywna funkcja Klonowanie głosu w Google AI Studio. Możesz nagrywać lub przesyłać klipy referencyjne i klipy z prośbą o zgodę bezpośrednio w przeglądarce, wyświetlać podgląd głosu i kopiować uzyskany voice_...identyfikator bezpośrednio do kodu aplikacji.
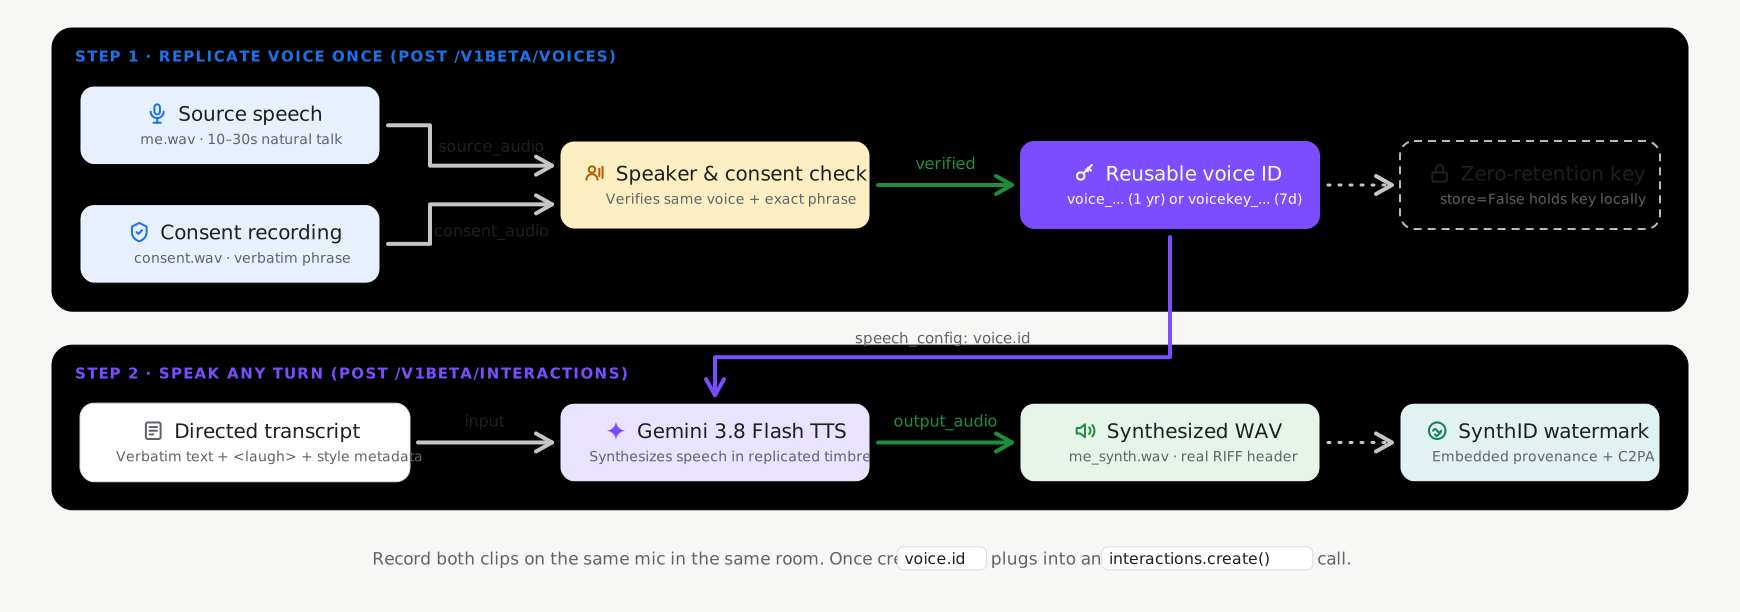
Tryby pamięci stanowej i bezstanowej
Replikacja głosu obsługuje 2 tryby przechowywania podczas połączeń voices.create(POST /v1beta/voices), przy czym domyślnie włączone jest przechowywanie stanowe:
- Pamięć stanowa (
store=True, zalecana wartość domyślna): Google przechowuje zweryfikowany profil głosowy w Twoim projekcie i zwraca lekki, trwały identyfikatorvoice_id(replicated_voice.id, np.voice_abc123...). Możesz przekazywać ten identyfikatorvoice_idw ramach żądań i zarządzać nim za pomocąvoices.list(),voices.get()ivoices.delete(). - Klucze zarządzane przez klienta bezstanowego (
store=False, opcjonalnie): w przypadku obciążeń wymagających zerowej trwałości po stronie serwera w odniesieniu do biometrycznych profili głosowych ustaw wartośćstore=False. Interfejs API zwraca zaszyfrowany, samodzielnyvoice_key(replicated_voice.key, zaczynający się odvoicekey_...), który Twoja aplikacja przechowuje lokalnie i przekazuje bezpośrednio w żądaniach syntezy.
| Tryb przechowywania | Identyfikator | Limit projektów | Przechowywanie (TTL) |
|---|---|---|---|
Głosy stanowe (store=True) |
voice_... |
200 głosów na projekt (wspólnych dla głosów wygenerowanych na podstawie promptów i replikowanych) | 1 rok |
Klawisze głosowe bezstanowe (store=False) |
voicekey_... |
Zarządzane przez klienta | 7 dni |
Wymagania dotyczące dźwięku i zgody użytkownika
Każde CreateVoiceżądanie replikacji wymaga 2 nagranych przez prawdziwych ludzi nagrań dźwiękowych tego samego dorosłego mówcy (zalecany format to 24 kHz mono 16-bit WAV):
- Dźwięk referencyjny (
source_audio): 10–30-sekundowy klip z czystą, naturalną mową osoby, której głos chcesz sklonować. - Nagranie dźwiękowe z oświadczeniem o zgodzie (
consent_audio): nagranie, na którym ta sama osoba wyraźnie odczytuje obowiązkowe oświadczenie o zgodzie w jednym z obsługiwanych języków (np. w języku angielskim): > „Jestem właścicielem tego głosu i zgadzam się na użycie przez Google tego głosu do utworzenia modelu głosu syntetycznego”.
Tworzenie replikowanego głosu (domyślny stanowy)
Użyj pakietu Google GenAI SDK (google-genai 2.25.0 lub nowszego / @google/genai 2.24.0 lub nowszego) lub interfejsu REST API z store=True, aby utworzyć i zapisać w projekcie zreplikowany profil głosu:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
Syntezowanie mowy za pomocą sklonowanego głosu
Przekaż zwrócony znak id (voice_...) w żądaniu syntezy:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
Zarządzanie przechowywanymi replikami głosu
Gdy utworzysz replikowane głosy za pomocą parametru store=True, możesz je wyświetlać, filtrować, sprawdzać i usuwać za pomocą interfejsu Voices API (wszystkie parametry filtrowania znajdziesz w sekcji Rozszerzona biblioteka głosów i filtrowanie):
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Opcja: bezstanowe klucze głosowe zarządzane przez klienta (store=False)
Jeśli Twoja aplikacja nie wymaga żadnego utrwalania profili głosowych po stronie serwera, podczas tworzenia replikowanego głosu ustaw wartość store=False. Interfejs API zwraca zaszyfrowany identyfikatorvoice_key (replicated_voice.key, zaczynający się od voicekey_...), który możesz przechowywać po stronie klienta i przekazywać bezpośrednio w każdym miejscu, w którym akceptowany jest identyfikator voice:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
Obsługiwane zwroty dotyczące zgody użytkownika w poszczególnych językach
Ścieżka dźwiękowa z prośbą o zgodę na przetwarzanie danych osobowych musi zawierać dokładne oświadczenie w jednym z 30 obsługiwanych języków:
| Język | Język (lang_id) |
Treść oświadczenia o uzyskaniu zgody |
|---|---|---|
| arabski | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| bengalski | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| chiński (uproszczony) | zh-CN |
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| niderlandzki | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| angielski (USA) | en-US |
Jestem właścicielem tego głosu i zgadzam się na użycie przez Google tego głosu do utworzenia modelu głosu syntetycznego. |
| English (UK) | en-GB |
Jestem właścicielem tego głosu i zgadzam się na użycie przez Google tego głosu do utworzenia modelu głosu syntetycznego. |
| angielski (Indie) | en-IN |
Jestem właścicielem tego głosu i zgadzam się na użycie przez Google tego głosu do utworzenia modelu głosu syntetycznego. |
| angielski (Australia) | en-AU |
Jestem właścicielem tego głosu i zgadzam się na użycie przez Google tego głosu do utworzenia modelu głosu syntetycznego. |
| francuski (Francja) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| francuski (Kanada) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| niemiecki | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| gudżarati, | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| hindi | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| indonezyjski | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| włoski | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| japoński | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| Kannada | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| koreański | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| malajalam, | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| marathi | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| polski | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| portugalski (Brazylia) | pt-BR |
Sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| rosyjski | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| Hiszpański (Hiszpania) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| hiszpański (USA) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| tamilski | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| telugu | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| tajski | th-TH |
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์ |
| turecki | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| wietnamski | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
Sprawdzone metody nagrywania dźwięku referencyjnego
- Nagrywaj w cichym otoczeniu: zminimalizuj pogłos w pomieszczeniu, szum w tle, muzykę i nakładające się głosy.
- Zgodność warunków nagrywania: nagraj oba fragmenty
source_audioiconsent_audioza pomocą tego samego mikrofonu w tych samych warunkach akustycznych, aby weryfikacja mówcy przebiegała prawidłowo. - Konwertuj na 24 kHz mono WAV: aby uzyskać najlepsze wyniki, przed kodowaniem ponownie próbkuj dźwięk wejściowy do formatu 24 kHz mono 16-bit PCM WAV.
Co dalej?
- Dowiedz się, jak tworzyć niestandardowe persony na podstawie opisów tekstowych w sekcji Projektowanie głosu.
- Więcej informacji o stylizacji na poziomie wypowiedzi, tagach wstawianych i dialogach z udziałem wielu rozmówców znajdziesz w przewodniku po zamianie tekstu na mowę.