

 Lihat di ai.google.dev |
 Jalankan di Google Colab |
 Jalankan di Kaggle |
 Buka di Vertex AI |
 Lihat sumber di GitHub |
Untuk meningkatkan kecepatan inferensi model Gemma 4, serangkaian model “drafter” autoregresif baru telah dirilis bersama dengan model utama. Daripada hanya mengandalkan model Gemma 4 utama (disebut sebagai model “target”), model draf memprediksi beberapa token autoregresif dalam waktu yang dibutuhkan model target untuk memproses hanya satu token. Teknik ini juga dikenal sebagai decoding spekulatif.
Setelah drafter memprediksi beberapa token draf, model target kini hanya perlu memverifikasi token draf yang disarankan tersebut. Verifikasi dilakukan secara paralel sehingga mempercepat inferensi secara drastis. Hal ini mengurangi jumlah penerusan ke depan yang harus dilakukan model target untuk setiap token. Karena drafter kami menghasilkan urutan token untuk verifikasi, kami menyebutnya sebagai head Prediksi Multi-Token (MTP).
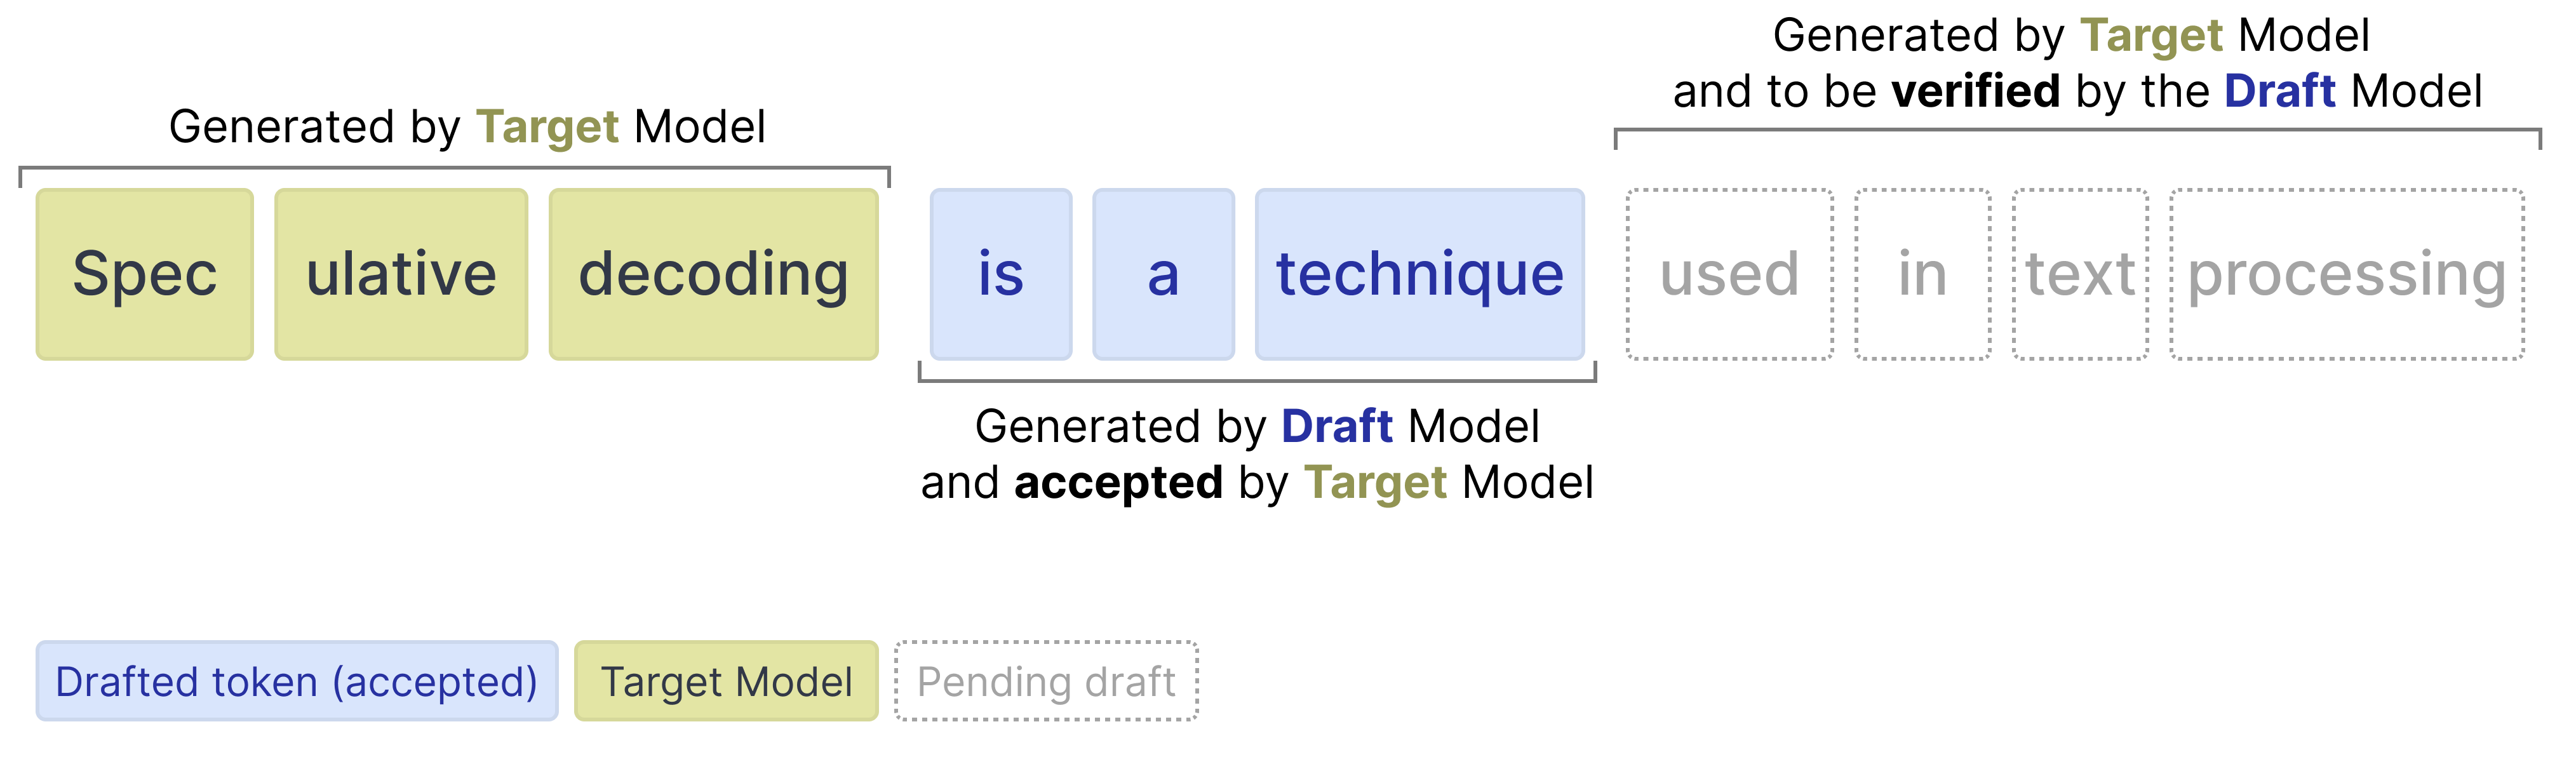
Model draf yang dirilis untuk keluarga Gemma 4 berukuran kecil dan memperkenalkan beberapa peningkatan untuk meningkatkan kualitas token draf dan lebih mempercepat inferensi, seperti menggunakan aktivasi model target dan cache KV untuk mendapatkan prediksi yang lebih baik.
Peningkatan ini menghasilkan percepatan decoding yang signifikan sekaligus menjamin kualitas yang serupa, sehingga checkpoint ini sangat cocok untuk aplikasi dengan latensi rendah dan di perangkat.
Menginstal paket Python
Instal library Hugging Face yang diperlukan untuk menjalankan model asisten Gemma 4 dan Gemma 4.
# Install PyTorch & other librariespip install torch accelerate# Install the transformers librarypip install transformers
Memuat Model
Untuk setiap model target (salah satu model utama dalam model Gemma 4), ada asisten yang membantu mempercepat inferensi. Dengan demikian, Anda akan memuat dua model:
- Target (misalnya,
google/gemma-4-E2B-it): Model target Gemma 4 lengkap - Drafter (misalnya,
google/gemma-4-E2B-it-assistant): Drafter MTP 4 lapis ringan yang mengusulkan token kandidat
Perhatikan bahwa drafter sering disebut sebagai asisten karena model ini membantu model yang lebih besar dalam memilih token yang akan diprediksi.
Gunakan library transformers untuk membuat instance processor dan model menggunakan class AutoProcessor dan AutoModelForCausalLM seperti yang ditunjukkan dalam contoh kode berikut:
TARGET_MODEL_ID = "google/gemma-4-E2B-it" # @param ["google/gemma-4-E2B-it", "google/gemma-4-E4B-it", "google/gemma-4-12B-it", "google/gemma-4-31B-it", "google/gemma-4-26B-A4B-it"]
ASSISTANT_MODEL_ID = TARGET_MODEL_ID + "-assistant"
import torch
from transformers import AutoProcessor, AutoModelForCausalLM

# Target Model
processor = AutoProcessor.from_pretrained(TARGET_MODEL_ID)
target_model = AutoModelForCausalLM.from_pretrained(
    TARGET_MODEL_ID,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

# Assistant Model (the drafter)
assistant_model = AutoModelForCausalLM.from_pretrained(
    ASSISTANT_MODEL_ID,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
[transformers] `torch_dtype` is deprecated! Use `dtype` instead!
Loading weights:   0%|          | 0/1951 [00:00<?, ?it/s]
Loading weights:   0%|          | 0/50 [00:00<?, ?it/s]
Gemma 4 dengan Asisten
Untungnya, menggunakan asisten di transformers cukup mudah dan mengharuskan Anda meneruskan model asisten ke fungsi model.generate:
# Process inputs with the `target_model`
messages = [
    {
        "role": "user",
        "content": "Explain the concepts of speculative decoding and MTP in 3 sentences."
    }
]
input_text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
inputs = processor(text=input_text, return_tensors="pt").to(target_model.device)

# `assistant_model=assistant_model` is all you need to enable MTP!
outputs = target_model.generate(
    **inputs,
    assistant_model=assistant_model,
    max_new_tokens=256,
    do_sample=False,
)

# Decode the response into text
response = processor.decode(outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
print(response)
**Speculative decoding** is a technique where a smaller, faster language model (the "draft model") generates several candidate tokens, which are then quickly verified by a larger, more accurate model to produce a final, high-quality output much faster than decoding the large model alone. **MTP (Multi-Task Prediction)** involves training a single model to perform multiple related tasks simultaneously, allowing it to leverage shared knowledge across different objectives. Together, these methods aim to significantly accelerate the inference speed of large language models while maintaining or improving output quality.
Di balik layar, prosesnya adalah sebagai berikut:
- Drafter mengusulkan N token yang dihasilkan secara autoregresif
- Model target memverifikasi semua N token dalam satu penerusan ke depan
- Token draf dengan probabilitas tinggi diterima
- Token draf dengan probabilitas rendah ditolak
- Karena model target melakukan penerusan ke depan, model ini akan selalu menghasilkan 1 token dengan sendirinya, terlepas dari berapa banyak token draf yang diterima atau ditolak
Token Draf
Drafter dapat menghasilkan token dalam jumlah berapa pun untuk diverifikasi oleh model target. Namun, model target masih dapat memilih untuk menolak token tertentu. Jika demikian, semua token setelah itu akan diabaikan.
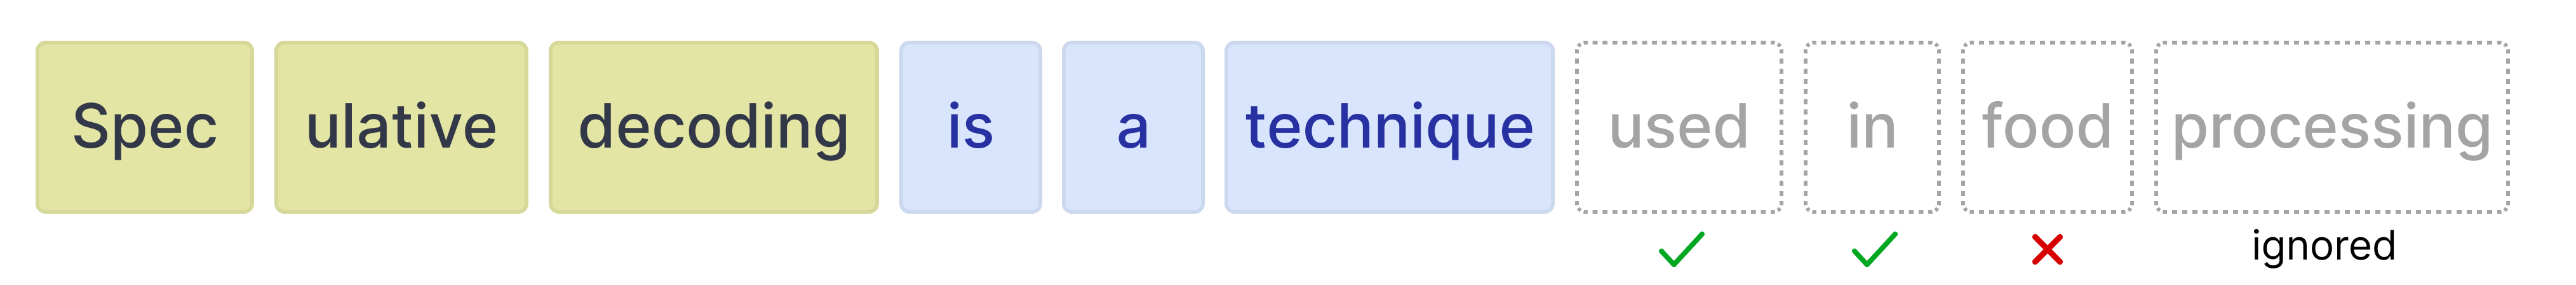
Oleh karena itu, penting untuk mengetahui kompromi saat menggunakan berbagai nilai untuk jumlah token draf.
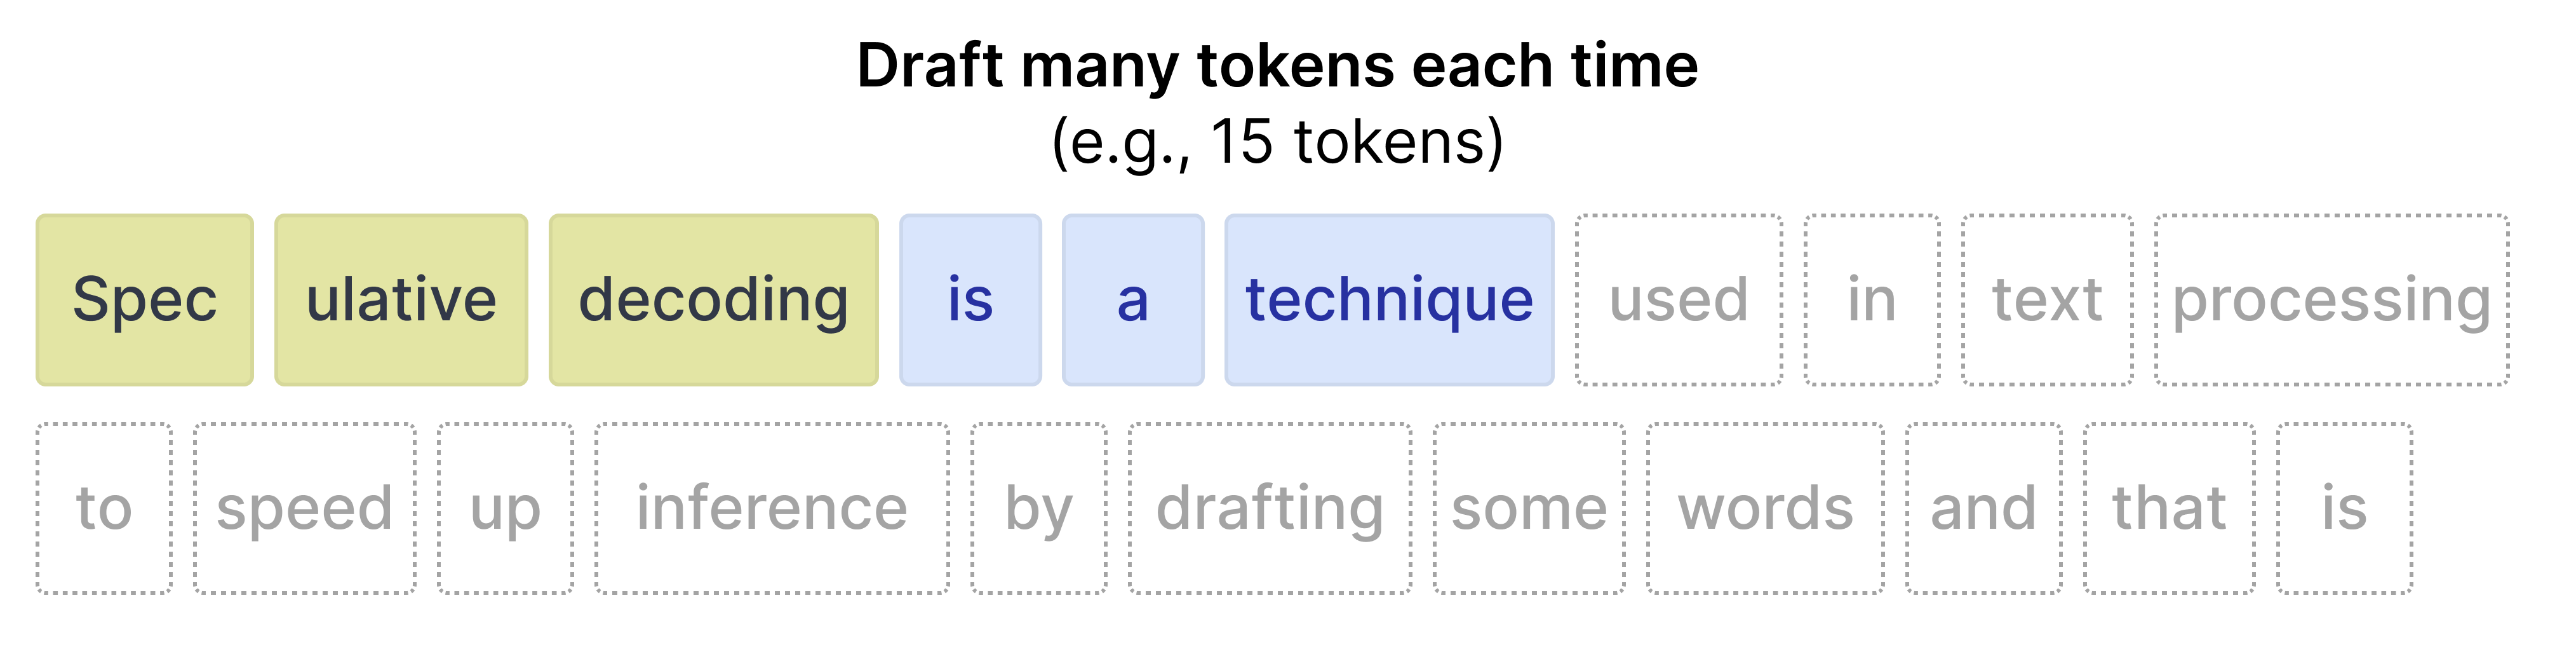
Lebih banyak token draf
Jika Anda membuat draf banyak token (misalnya 15), kemungkinan besar tidak semua token akan diterima. Dengan demikian, ada potensi yang lebih besar untuk komputasi yang terbuang. Sebaliknya, hal ini cenderung mempercepat inferensi jika tingkat penerimaannya tinggi.
Lebih sedikit token draf
Jika Anda membuat draf lebih sedikit token, tingkat penerimaannya cenderung lebih tinggi karena token yang posisinya lebih dekat dengan perintah awal lebih akurat. Namun, karena hanya beberapa token yang dibuat draf, percepatan yang akan Anda dapatkan dari model drafter yang lebih cepat akan berkurang.
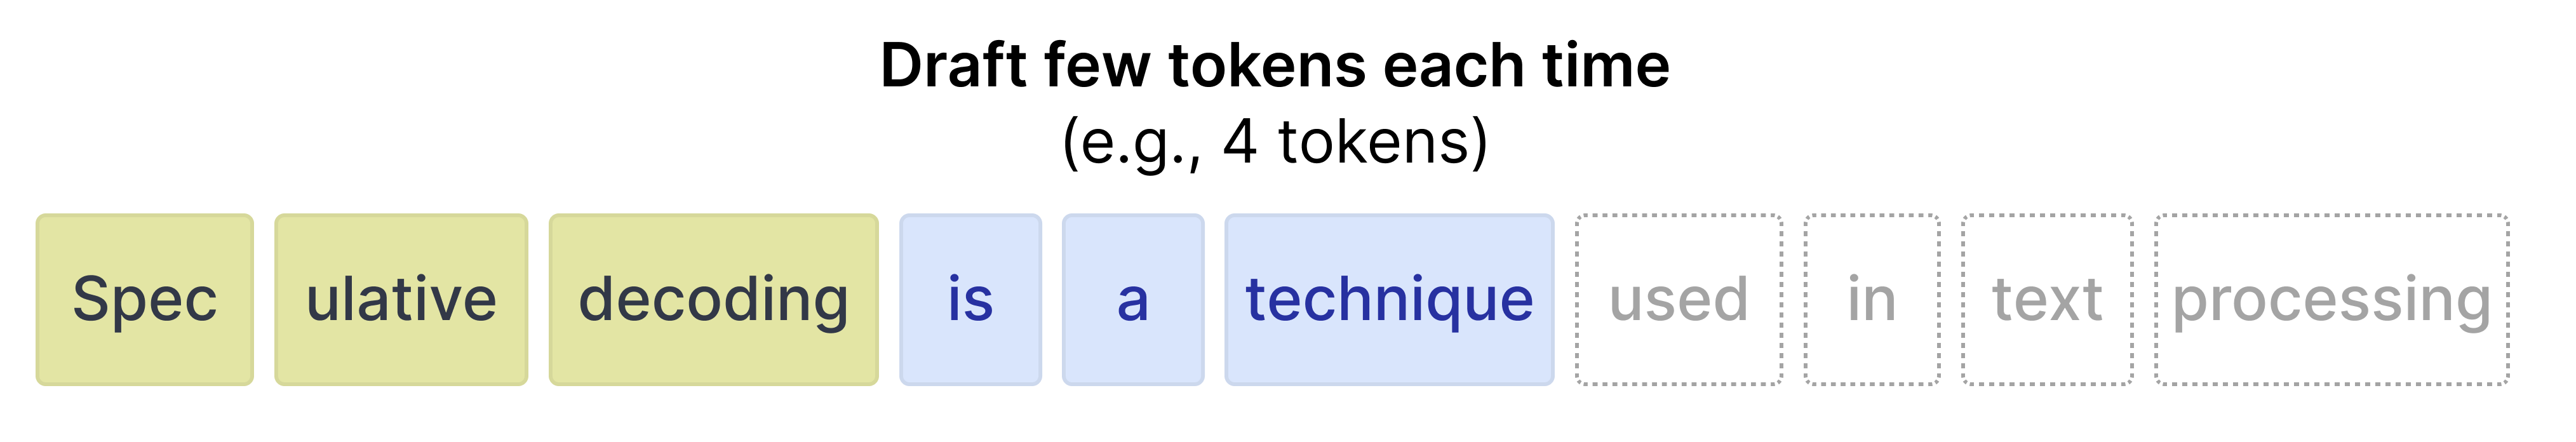
Untungnya, Anda tidak perlu bereksperimen dengan nilai terbaik untuk kasus penggunaan Anda di transformers karena Anda dapat menetapkan num_assistant_tokens_schedule ke "heuristik" yang akan otomatis menyesuaikan jumlah token draf saat runtime:
- Semua token diterima -- Tingkatkan jumlah token yang akan dibuat draf sebanyak 2 karena drafter cukup akurat untuk perintah. Meningkatkan jumlah token yang dibuat draf dapat mempercepat proses jika token tersebut juga diterima.
- Token ditolak -- Jika ada token yang ditolak, kurangi jumlah token yang akan dibuat draf sebanyak 1. Mengurangi jumlah token akan memastikan tidak terlalu banyak draf yang terbuang jika model target terus menolak sebagian besar token.
Demikian pula, Anda dapat memperbarui jumlah token draf dengan memperbarui num_assistant_tokens di drafter seperti berikut:
# Update how many draft tokens are generated at the start of inference
assistant_model.generation_config.num_assistant_tokens = 4

# Update how the number of draft tokens are updated ("heuristic" for a dynamic schedule and "constant" for a constant schedule)
assistant_model.generation_config.num_assistant_tokens_schedule = "heuristic"

# Run with MTP
outputs = target_model.generate(
    **inputs,
    assistant_model=assistant_model,
    max_new_tokens=256,
    do_sample=False,
)

# Decode the response into text
response = processor.decode(outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
print(response)
**Speculative decoding** is a technique where a smaller, faster language model (the "draft model") generates several candidate tokens, which are then verified by a larger, more accurate model to quickly produce a high-quality output. **MTP (Multi-Task Prediction)** involves training a single model to perform multiple related tasks simultaneously, allowing it to leverage shared knowledge across different objectives. Together, these methods aim to significantly speed up the inference process of large language models while maintaining or improving output quality.