

رابط برنامهنویسی نرمافزار Gemini Live امکان مکالمات صوتی دوطرفه و بلادرنگ با مدلهای Gemini را فراهم میکند.
مدلهای صوتی استاندارد برای گفتگوی فوری و رو در رو به خوبی کار میکنند. شما با مدل صحبت میکنید و مدل بلافاصله پاسخی شفاهی تولید میکند. اما وقتی درخواستی نیاز به برنامهریزی، تجزیه و تحلیل پیچیده یا ابزارهای خارجی دارد، پاسخهای مستقیم با محدودیت مواجه میشوند. مدل یا باید بدون استدلال پاسخ دهد یا در سکوت مکث کند تا ابزارها کار خود را تمام کنند.
تفکر در API زنده ( gemini-3.8-live-extended-thinking ) استدلال پسزمینه را به جلسات صوتی بلادرنگ اضافه میکند. این مدل، ابزارهای غیرهمزمان را در پسزمینه برنامهریزی و فراخوانی میکند، در حالی که از پرکنندههای مکالمه طبیعی برای فعال نگه داشتن تعامل استفاده میکند.
این معماری چرخه حیات مکالمه را از دو طریق کلیدی تغییر میدهد:
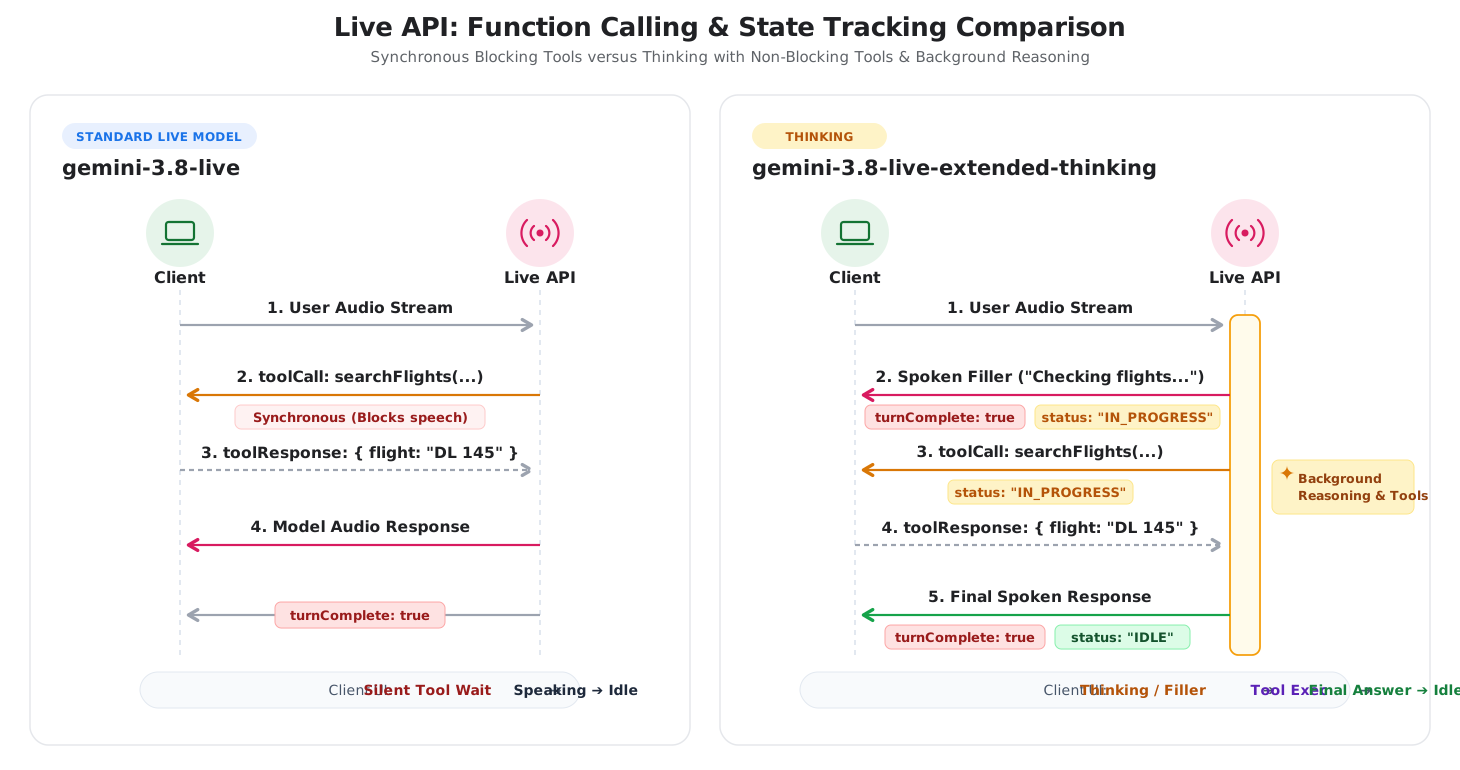
- پرکنندههای مکالمه : مدل بهروزرسانیهای میانی (مانند «در حال بررسی گزینههای پرواز») را در حین اجرای ابزارها در پسزمینه بیان میکند.
- ردیابی وضعیت تعامل : از آنجا که مدل میتواند در طول یک درخواست واحد چندین بار صحبت کند، سرور در طول پردازش پسزمینه،
interaction_status: "IN_PROGRESS"و پس از اتمام کل وظیفهinteraction_status: "IDLE"را منتشر میکند.
نمودار زیر چرخه حیات تعامل بین جلسات صوتی زنده استاندارد و تفکر با استدلال پسزمینه را مقایسه میکند:
انتخاب مدل مناسب
هنگام تصمیمگیری بین gemini-3.8-live و gemini-3.8-live-extended-thinking ، سه ملاحظه اصلی را در نظر بگیرید: تأخیر پاسخ، پیچیدگی وظیفه و مدیریت وضعیت کلاینت.
چه زمانی از Gemini 3.8 Live استفاده کنیم؟
gemini-3.8-live برای عوامل صوتی مکالمهای با تأخیر کم استفاده کنید، جایی که نوبتگیری فوری ضروری است و وظایف مستقیم هستند.
- دستیارهای صوتی مکالمهای : اولویتبندی خدمات مشتری، تمرین زبان، جستجوی صوتی و داستانسرایی تعاملی.
- اجرای سریع ابزار : گردشهای کاری که در آنها ابزارهای خارجی در عرض چند میلیثانیه برمیگردند (مانند خواندن مقادیر حسگر یا کنترل دستگاههای هوشمند).
- منطق ساده کلاینت : برنامههایی که در آنها هر کاربر turn یک پاسخ مدل واحد دریافت میکند، و
turnComplete: trueبه طور قابل اعتمادی زمان غیرفعال بودن session را اعلام میکند.
چه زمانی از Gemini 3.8 Live Extended Thinking استفاده کنیم؟
زمانی که نماینده شما باید دادههای پیچیده را ارزیابی کند، چندین مرحله را برنامهریزی کند یا ابزارهایی را مدیریت کند که اجرای آنها چند ثانیه طول میکشد، از gemini-3.8-live-extended-thinking استفاده کنید.
- تشخیص و پشتیبانی چند مرحلهای : کارشناسان پشتیبانی فنی، مشکلات سیستم را از طریق چندین گزارش، کدهای خطا و بررسیهای پیکربندی تشخیص میدهند.
- بازیابی هماهنگ دادهها : آژانسهای مسافرتی و رزرو که پروازها را جستجو میکنند، هتلها را جستجو میکنند و قیمتها را در فراخوانیهای موازی API مقایسه میکنند.
- آموزش STEM و کدنویسی : عوامل آموزشی که فرمولها را تأیید میکنند، کد را اشکالزدایی میکنند یا قبل از بیان توضیح، منطق چند مرحلهای را بررسی میکنند.
- پنهان کردن تأخیر ابزار : تجربههای صوتی که در آنها عملکردهای طولانیمدت، سکوت ناخوشایندی را برای شنونده ایجاد میکنند.
خلاصه تفاوتهای کلیدی
جدول زیر خلاصهای از تفاوتهای فنی بین این دو مدل را نشان میدهد:
| ویژگی | جمینی ۳.۸ زنده | تفکر گسترده زنده Gemini 3.8 |
|---|---|---|
| موارد استفاده اولیه | عوامل صوتی با تأخیر کم، دستورات مستقیم، ابزارهای سریع | حل مسئله چند مرحلهای، برنامهریزی پیچیده، گردشهای کاری چند ابزاری |
| نقطه پایانی مدل | gemini-3.8-live | gemini-3.8-live-extended-thinking |
| معماری استدلالی | استدلال لایهای با پروفایل تأخیر ثابت ( thinking_level پشتیبانی نمیشود) | استدلال پسزمینه قابل تنظیم ( thinking_level : low ، medium ، high ؛ MINIMAL پشتیبانی نمیشود) |
| مرزها را بچرخانید | turnComplete: true نوبت بسته شده و به حالت غیرفعال برمیگردد. | turnComplete: true یک عبارت را تمام میکند؛ interaction_status چرخه حیات جلسه را کنترل میکند. |
| پرکنندههای مکالمه | مدل قبل از صحبت کردن منتظر اجرای ابزار میماند | مدل، پرکنندههای مکالمهای میانی را هنگام پردازش، جریان میدهد. |
| اجرای ابزار | پشتیبانی از ابزارهای همزمان ( BLOCKING ) و غیرهمزمان ( NON_BLOCKING ) | به اعلانهای ابزار ناهمزمان ( NON_BLOCKING ) نیاز دارد |
مسیرهای مهاجرت و ادغام
برای ارتقاء برنامههای صوتی موجود یا ادغام Thinking در جلسات Live API خود، این مراحل را دنبال کنید.
ارتقا از Gemini 3.1 Flash Live
برای برنامههای صوتی موجود که از gemini-3.1-flash-live-preview استفاده میکنند، ارتقا به gemini-3.8-live نیاز به بهروزرسانی رشته مدل و حذف thinking_level (یا thinking_config ) از پیکربندی تنظیمات شما دارد، زیرا thinking_level برای gemini-3.8-live پشتیبانی نمیشود:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
سیگنالهای چرخه حیات نوبت و turnComplete یکسان باقی میمانند.
اتخاذ تفکر
برای اتخاذ gemini-3.8-live-extended-thinking ، سه نکتهی ادغام را بهروزرسانی کنید:
ردیابی
interaction_statusبه جایturnComplete: در جلسات تفکر، مدل میتواند هنگام استدلال، پرکنندههای مکالمهای میانی را منتشر کند. فیلدinteraction_statusرا در پیامهای ورودی سرور بررسی کنید تا وضعیت رابط کاربری را مدیریت کنید. فقط زمانی کهinteraction_statusIDLEباشد، به حالت غیرفعال برگردید.پایتون
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
جاوا اسکریپت
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
توابع غیر مسدودکننده را تعریف کنید : برای تمام تعریفهای توابع
"behavior": "NON_BLOCKING"تنظیم کنید. مدلهای تفکر، ابزارها را به صورت ناهمگام در پسزمینه اجرا میکنند و در عین حال بهروزرسانیهای کلامی را نیز پخش میکنند. ابزارهای مسدودکننده همزمان، خطا برمیگردانند.پایتون
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
جاوا اسکریپت
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
پیکربندی عمق استدلال : برای تنظیم سطوح استدلال (
low،mediumیاhigh؛MINIMALپشتیبانی نمیشود)،thinking_configدر پیکربندی جلسه خود تنظیم کنید.پایتون
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
جاوا اسکریپت
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
مقایسه پروتکلها در کنار هم
این بخش پیامهای WebSocket رد و بدل شده در هر مرحله از یک جلسه Live API را مقایسه میکند.
مرحله ۱: تنظیمات جلسه
هر دو مدل به یک نقطه پایانی WebSocket متصل میشوند:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- یکسان : احراز هویت URL وبساکت و کلید API.
- رشته مدل :
gemini-3.8-liveدر مقابلgemini-3.8-live-extended-thinking. - پیکربندی Thinking : Thinking برای تنظیم عمق استدلال،
thinkingConfigرا اضافه میکند. رفتار ابزار : تفکر مستلزم
"behavior": "NON_BLOCKING"در تعریف توابع.
جمینی ۳.۸ زنده
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
تفکر گسترده زنده Gemini 3.8
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
هر دو مدل هنگام اتصال، تأییدیه سرور یکسانی دریافت میکنند:
{
  "setupComplete": {}
}
مرحله ۲: ورودی صدای کاربر
پخش صدا در هر دو مدل یکسان است. قطعات صوتی خام PCM با فرکانس ۱۶ کیلوهرتز به صورت بلادرنگ با استفاده از realtimeInput پخش میشوند:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
مرحله ۳: چرخه حیات پاسخ و حالت مدل
هر دو مدل، قطعات صوتی PCM با فرکانس ۲۴ کیلوهرتز را در serverContent.modelTurn پخش میکنند. با این حال، مدیریت چرخه عمر آنها متفاوت است:
جریان پاسخ زنده Gemini 3.8
- سرور بخشهای صوتی را برای نوبت پخش میکند.
- سرور
turnComplete: trueارسال میکند که نشان میدهد مدل صحبت کردن را تمام کرده و جلسه غیرفعال است.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
جریان پاسخ تفکر توسعهیافتهی زندهی Gemini 3.8
- پرکننده گفتاری : مدل گفتار میانی (مانند "بررسی پروازهای سیاتل..." ) را با
turnComplete: trueوinteractionStatus: "IN_PROGRESS"منتشر میکند. - فراخوانی ابزار ناهمزمان : سرور فراخوانی ابزار را منتشر میکند در حالی که
interactionStatus"IN_PROGRESS"باقی میماند، که نشان میدهد سرور به طور فعال چرخش چند مرحلهای را پردازش میکند و منتظر پاسخ ابزار است. - پاسخ ابزار : کلاینت تابع را اجرا میکند و خروجی را برمیگرداند.
- پاسخ نهایی : سرور پاسخ کامل را با
turnComplete: trueوinteractionStatus: "IDLE"ارائه میدهد.
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
نمونههای پیادهسازی SDK
مثالهای زیر نحوه پیکربندی Thinking و مدیریت interaction_status با استفاده از Google GenAI SDK نشان میدهند.
پایتون
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
جاوا اسکریپت
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
قدم بعدی چیست؟
- صفحات مدل Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking را مطالعه کنید.
- برای مقایسه دقیق ویژگیها در تمام مدلهای Live API، جدول مقایسه مدلها را بررسی کنید.
- برای کسب اطلاعات بیشتر در مورد فراخوانی تابع، به راهنمای استفاده از ابزار Live API مراجعه کنید.
- مدیریت جلسه (Session management) را برای مدیریت از سرگیری جلسه (session resurgence) و چرخه حیات زمینه (context lifecycle) مرور کنید.