

Gemini Robotics ER(身体化された推論)モデルは、ロボットが物理世界を認識して操作できるようにする視覚言語モデル(VLM)です。視覚データを解釈し、空間的および時間的な推論を行い、マルチステップのタスクを計画し、ロボットとツールをオーケストレートします。
モデル
Gemini Robotics ER 2 モデルは、Gemini Robotics の最新モデルです。これは、ロボットが環境を正確に理解できるようにする、更新された推論モデルです。ロボットのエージェント オーケストレーション(VLA の使用など)、進捗状況の理解や成功検出を含むロボット動画の理解、計器の読み取り、ポインティング、空間推論など、身体化された推論機能に特化しています。
Gemini Robotics ER 2 モデルには、次の 2 つのモデル エンドポイントが導入されています。
gemini-robotics-er-2-preview: 標準の ER 2 モデル。Gemini 3.5 Flash をベースに、空間推論、動画の瞬間検索、動画の進行状況の分類、マルチロボット オーケストレーション、マルチステップ ツール使用が改善されています。gemini-robotics-er-2-streaming-preview: Live API を使用したリアルタイム ストリーミング用に最適化されています。このモデルは、連続した音声入力と動画入力を処理する低レイテンシのロボット エージェントに使用します。
Gemini Robotics ER 1.6 は 2026 年 8 月 31 日に非推奨となりました。Gemini Robotics ER 1.6 をまだ使用している場合は、API 呼び出しで model="gemini-robotics-er-1.6-preview" を model="gemini-robotics-er-2-preview" または model="gemini-robotics-er-2-streaming-preview" に置き換えて、Gemini Robotics ER 2 にアップグレードしてください。
Google AI Studio で Gemini Robotics ER 2 を試す
ロボティクス機能
Gemini Robotics-ER は、さまざまな身体化された推論機能をサポートしています。機能を選択して詳細を表示
| 能力 | 説明 | ガイド |
|---|---|---|
| 空間推論 | オブジェクトを指し示し、動画内で追跡し、境界ボックスで検出し、軌道を計画します。 | 空間推論 |
| エージェント ビジョン | コード実行を使用して、画像操作ツールを活用して他の機能を強化します。 | エージェント ビジョン |
| タスク オーケストレーション | 空間推論とカスタム ロボット API を組み合わせて、長期的なタスクを完了します。 | タスク オーケストレーション |
| ストリーミング(Gemini Robotics ER 2 ストリーミング エンドポイントのみ) | 低レイテンシの関数呼び出しによるリアルタイム ロボット エージェントの双方向ストリーミング。 | ロボット工学向けのストリーミング |
| 動画の進行状況(Gemini Robotics ER 2 のみ) | 連続した動画フィードからのモーメント検出と進行状況の分類。 | 動画に関する理解を深める |
始める前に
Gemini Robotics ER モデルは、Gemini Developer API を介して利用できます。まず、Google AI Studio または Google Cloud コンソールから Gemini API キーを作成し、環境を設定します。
キーの種類、セキュリティ、Python、JavaScript などの言語でキーを構成する方法については、Gemini API キーの使用をご覧ください。
スタートガイド
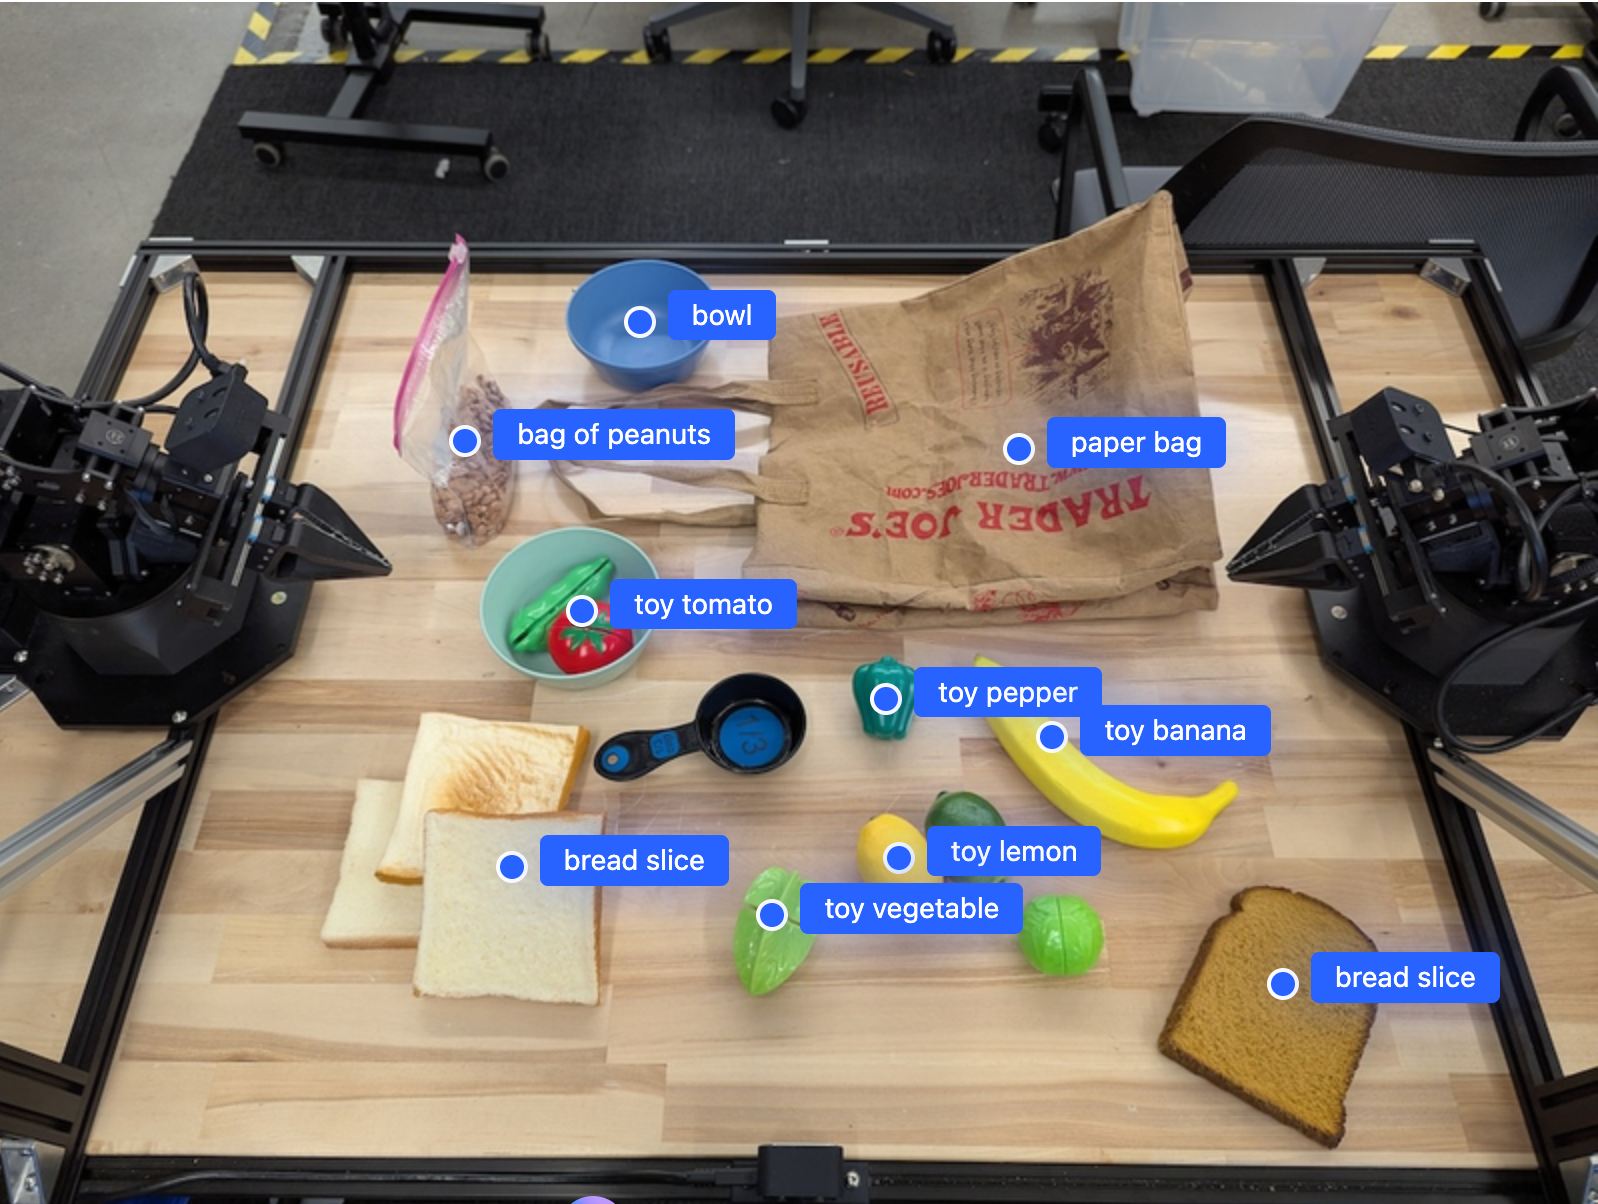
次の例では、画像内のオブジェクトを検出し、正規化された 2D 座標とラベルを返します。この出力をロボティクス API または VLA モデルに直接渡して、ロボット アクションを生成できます。
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
出力は、オブジェクトを含む JSON 配列になります。各オブジェクトには、point(正規化された [y, x] 座標)と、オブジェクトを識別する label が含まれます。
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
次の画像は、これらのポイントの表示例です。
仕組み
Gemini Robotics ER は、自然言語プロンプトを使用して画像、動画、音声の入力を受け取ります。オブジェクトを識別し、シーンのコンテキストと空間関係を推論して、座標や境界ボックスなどの構造化された出力を返します。
Gemini Robotics ER はエージェント型でもあります。複雑なタスクをサブタスクに分割し、ロボット関数を呼び出すか、生成されたコードを実行して、それらのサブタスクを実行します。たとえば、「リンゴをボウルに入れる」は、位置を特定し、つかみ、置くという一連のステップになります。
Gemini がツール呼び出しを実行する方法の詳細については、関数呼び出しをご覧ください。
安全性
Gemini Robotics ER は安全性を考慮して構築されていますが、ロボットの周囲の安全な環境を維持することはユーザーの責任です。生成 AI モデルは間違えることがあり、物理的なロボットは損傷を引き起こす可能性があります。詳細については、Gemini Robotics の安全性に関するページをご覧ください。
ベスト プラクティス
わかりやすく自然言語を使用します。ロボットにさせたいことを、人に伝えるように説明します。用語が機能しない場合は、一般的な類義語を試してください。
視覚入力を最適化します。画像を送信する前に、小さいオブジェクトや不鮮明なオブジェクトを切り抜くか、ズームします。照明や色のコントラストが低いと、検出に影響することがあります。
複雑なタスクをステップに分割する。各ステップを個別のプロンプトとして送信して、モデルの焦点を維持し、精度を向上させます。
高精度のタスクでは、クエリを複数回実行して結果を平均化します。このコンセンサス アプローチにより、空間出力の分散が減少します。
制限事項
Gemini Robotics ER を使用して開発する場合は、次の制限事項を考慮してください。
- API キーの制限: Gemini API は、制限のない API キーからのリクエストを受け付けず、
403 Forbiddenエラーを返します。AI Studio で制限を追加して API キーを保護します。詳細については、制限のない API キーを保護するをご覧ください。 - レイテンシとパフォーマンス: 複雑なクエリ、高解像度の入力、高い思考レベルは、処理時間の増加につながる可能性があります。思考レベルには、レイテンシとパフォーマンスのバランスが取れた medium を使用します。
- ハルシネーション: すべての大規模言語モデルと同様に、Gemini Robotics ER モデルは、特に曖昧なプロンプトや分布外の入力に対して、「ハルシネーション」を起こしたり、不正確な情報を提供したりすることがあります。
- プロンプトの品質に依存: 出力の品質は、入力プロンプトの明確さに依存します。具体的で、適切に構造化されたプロンプトを使用する。
- コンピューティング費用: モデルの実行(特に動画入力や高い
thinking_budgetを使用する場合)は、コンピューティング リソースを消費し、費用が発生します。詳細については、思考ページをご覧ください。 - 入力タイプ: 各モードの制限事項の詳細については、次のトピックをご覧ください。
プライバシーに関するお知らせ
このドキュメントで言及されているモデル(「ロボティクス モデル」)は、お客様の指示に従ってハードウェアを操作および移動するために、動画データと音声データを利用します。したがって、特定できる人物のデータ(音声、画像、肖像データなど)(「個人データ」)がロボティクス モデルによって収集されるように、ロボティクス モデルを操作できます。個人データを収集する方法でロボティクス モデルを運用することを選択した場合、特定できる人物が、https://ai.google.dev/gemini-api/terms に記載されている Gemini API の追加利用規約(以下「本規約」)に記載されているとおり、Google に個人データが提供され、Google によって使用される可能性があることを十分に通知され、同意するまで、特定できる人物がロボティクス モデルとやり取りしたり、ロボティクス モデルの周囲に存在したりすることを許可しないことに同意するものとします。これには、「Google によるデータの使用方法」というセクションに記載されている内容も含まれます。お客様は、当該通知が本規約に記載されている個人データの収集および使用を許可することを保証するものとします。また、お客様は、顔のぼかしなどの技術を使用し、特定できる人物が含まれていないエリアでロボティクス モデルを運用するなど、商業上合理的な努力を払って、個人データの収集および配布を最小限に抑えるものとします。
料金
料金と利用可能なリージョンの詳細については、料金ページをご覧ください。
モデル エンドポイント
Gemini Robotics ER 2 プレビュー
| プロパティ | 説明 |
|---|---|
| モデルコード | gemini-robotics-er-2-preview |
| サポートされるデータタイプ |
入力 テキスト、画像、動画、音声 出力 テキスト |
| トークンの上限[*] |
入力トークンの上限 131,072 出力トークンの上限 65,536 |
| 機能 | サポート対象外 サポート対象 サポート対象 サポート対象 サポート対象 サポート対象 サポート対象 サポート対象外 サポート対象外 サポート対象 サポート対象 サポート対象 サポート対象 |
| 使用オプション |
サポート対象 サポート対象外 サポート対象外 |
| バージョン |
|
| 最終更新 | 2026 年 7 月 |
| モデルカード | モデルカード |
Gemini Robotics ER 2 Streaming プレビュー
| プロパティ | 説明 |
|---|---|
| モデルコード | gemini-robotics-er-2-streaming-preview |
| サポートされるデータタイプ |
入力 テキスト、画像、動画、音声 出力 テキスト |
| トークンの上限[*] |
入力トークンの上限 131,072 出力トークンの上限 65,536 |
| 機能 | サポート対象外 サポート対象外 サポート対象外 サポート対象外 サポート対象外 サポート対象 サポート対象外 サポート対象外 サポート対象 サポート対象 サポート対象外 サポート対象 サポート対象外 |
| 使用オプション |
サポート対象外 サポート対象外 サポート対象外 |
| バージョン |
|
| 最終更新 | 2026 年 7 月 |
| モデルカード | モデルカード |
Gemini Robotics-ER 1.6 プレビュー版
| プロパティ | 説明 |
|---|---|
| モデルコード | gemini-robotics-er-1.6-preview |
| サポートされるデータタイプ |
入力 テキスト、画像、動画、音声 出力 テキスト |
| トークンの上限[*] |
入力トークンの上限 131,072 出力トークンの上限 65,536 |
| 機能 | サポート対象外 サポート対象 サポート対象 サポート対象 サポート対象 サポート対象 サポート対象 サポート対象外 サポート対象外 サポート対象 サポート対象 サポート対象 サポート対象 |
| 使用オプション |
サポート対象 サポート対象外 サポート対象外 |
| バージョン |
|
| 最終更新 | 2025 年 12 月 |
| ナレッジ カットオフ | 2025 年 1 月 |
次のステップ
- 空間推論 - ポインティング、トラッキング、境界ボックス、軌跡。
- エージェント機能 - コード実行、計器の読み取り、画像アノテーション。
- タスク オーケストレーション - カスタム ロボット API を使用した長期的なタスク。
- ストリーミングを使用したロボティクス - リアルタイムの双方向ストリーミング(Gemini Robotics ER 2 のみ)。
- 動画理解 - モーメントの検出と進行状況の分類(Gemini Robotics ER 2 のみ)。
- Gemini Robotics の安全性 - モデル ファミリーの背後にある安全性に関する研究。